Tool Use (Function Calling)
- Langkah belajar
- 12
- Alat
- 3
- Proyek mini
- 2
- Sumber
- 15
Diperbarui 9 Oktober 2026
Overview
Model bahasa pandai bernalar dan menulis, tetapi ia tak bisa mengecek katalog, membaca kalender, atau mengirim email sendiri. Tool use, yang juga sering disebut function calling, adalah jembatannya. Kamu memperkenalkan beberapa tool (alat) kepada model: namanya, gunanya, dan bentuk masukannya. Ketika model merasa butuh salah satunya, ia tidak menjalankannya sendiri. Ia menulis permintaan yang rapi, semacam "tolong jalankan cari_buku dengan kata kunci ini", lalu aplikasimu yang mengerjakannya dan menyerahkan hasilnya kembali. Model membaca hasil itu dan melanjutkan, berulang sampai tugasnya beres. Putaran sederhana inilah jantung setiap agen AI, sekaligus dasar untuk memahami MCP. Di halaman ini kita belajar lewat Messages API Claude, lalu melihat bahwa OpenAI dan Gemini memakai gagasan yang sama dengan nama yang berbeda.
Pustakawan di ujung telepon
Bayangkan kamu menelepon seorang pustakawan yang sangat berpengetahuan, tetapi ia sedang berada di kota lain. Ia hafal ribuan judul, namun tak bisa melihat rak perpustakaanmu. Ketika kamu bertanya apakah Laskar Pelangi tersedia, ia tidak menebak. Ia berkata, "Tolong cek katalog dengan kata kunci Laskar Pelangi, lalu bacakan hasilnya." Kamu yang mengecek, kamu yang membacakan, dan dari laporanmu ia menyusun jawaban.
Model bahasa berada di posisi pustakawan itu. Ia pandai bernalar dan menulis, tetapi tak bisa menyentuh basis data, kalender, atau kotak suratmu. Tool use, yang juga disebut function calling, adalah cara memberinya "tangan": kamu memperkenalkan beberapa tool (alat) beserta cara memakainya, lalu model boleh memintamu menjalankan salah satunya.
Kata kuncinya adalah meminta. Dokumentasi resmi Claude menegaskan bahwa model tak pernah menjalankan apa pun sendiri. Ia menulis permintaan terstruktur, kodemu (atau server Anthropic, untuk beberapa tool bawaan) yang menjalankannya, lalu hasilnya kembali ke percakapan. Pembagian kerja inilah yang membuat tool use bisa dikendalikan: kuncinya tetap di tanganmu.
Kalau kamu biasa membuat API, polanya akan terasa akrab: tetapkan skema, tangani panggilan, kembalikan hasil. Bedanya, yang memanggil adalah model bahasa yang memilih berdasarkan isi percakapan. Kadang ia memanggil tool, kadang ia cukup menjawab dari pengetahuannya, dan kadang ia bertanya balik kepada pengguna.
Putaran yang berulang sampai tugas selesai
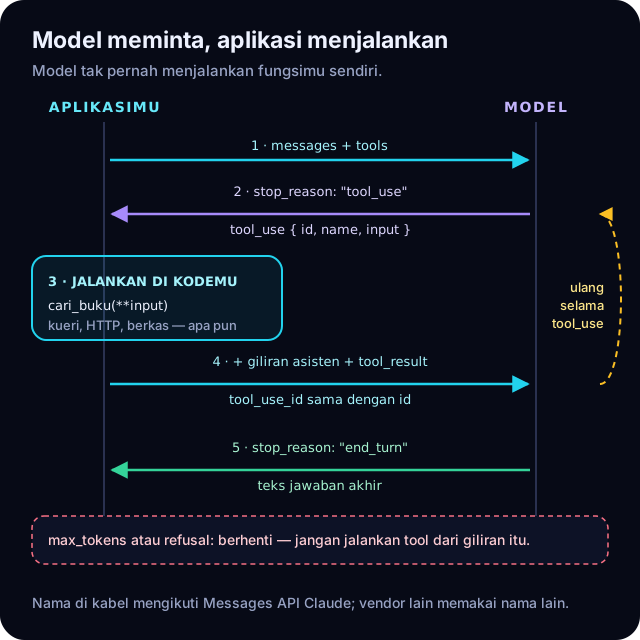
Satu pertanyaan bisa membutuhkan beberapa kali bolak-balik. Model meminta tool, kamu menjalankannya, model membaca hasilnya, lalu mungkin meminta tool lain. Bolak-balik inilah yang disebut putaran agen (agent loop), dan hampir setiap agen AI dibangun di atasnya.
Lalu bagaimana aplikasimu tahu kapan harus menjalankan tool dan kapan jawabannya sudah selesai? Setiap respons membawa penanda bernama stop_reason, yaitu alasan model berhenti menulis. Nilai inilah yang mengemudikan putaran:
stop_reason | Artinya | Yang dilakukan aplikasimu |
|---|---|---|
tool_use | model meminta satu atau lebih tool | jalankan, kirim tool_result, ulangi |
end_turn | jawaban selesai | tampilkan teksnya |
max_tokens | jawaban terpotong karena jatah token habis | jangan jalankan tool dari giliran itu; naikkan batasnya |
refusal | model menolak permintaan | jangan jalankan tool; tangani penolakannya |
pause_turn | putaran tool server mencapai batas iterasinya | kirim ulang percakapan apa adanya supaya model melanjutkan |
Dua baris di tengah sering terlupa. Respons yang terpotong atau ditolak bisa saja memuat permintaan tool, tetapi argumennya belum tentu utuh, jadi jangan dijalankan.
Memperkenalkan tool kepada model
Model hanya mengenal tool-mu dari definisinya. Ia tak pernah melihat kode di baliknya. Definisi itu terdiri dari beberapa medan:
| Medan | Isi |
|---|---|
name | nama tool, cocok dengan pola ^[a-zA-Z0-9_-]{1,128}$ |
description | apa yang dilakukan, kapan dipakai dan kapan tidak, arti tiap parameter, dan apa yang tidak dikembalikannya |
input_schema | bentuk argumennya, ditulis dalam JSON Schema |
input_examples | (opsional) contoh masukan; setiap contoh harus sah menurut skema, kalau tidak API menjawab galat 400 |
strict | (opsional) true berarti argumen dijamin cocok dengan skema |
Dari semua medan itu, deskripsilah yang paling menentukan. Dokumentasi Claude menyebutnya faktor terpenting bagi kinerja tool dan menganjurkan sedikitnya tiga sampai empat kalimat. Coba bayangkan menerima tugas dengan petunjuk sependek "Gets the stock price for a ticker." Harga kapan? Di bursa mana? Apa yang terjadi bila kodenya salah? Model menghadapi pertanyaan yang sama, dan ia tak bisa bertanya kepadamu.
Mengintip percakapan di balik layar
Seperti apa sebenarnya pesan yang bolak-balik itu? Misalkan pengguna menanyakan dua buku sekaligus, dan model meminta dua pencarian dalam satu giliran. Setelah aplikasi menjalankan keduanya, permintaan berikutnya ke API membawa dua pesan baru di bawah ini. Contoh ini bukan karangan: ia diambil dari permintaan yang benar-benar disusun SDK Python resmi (anthropic 1.12.1).
[
  {
    "role": "assistant",
    "content": [
      { "type": "text", "text": "Saya cek kedua buku itu di katalog." },
      { "type": "tool_use", "id": "toolu_01A", "name": "cari_buku",
        "input": { "kata_kunci": "Laskar Pelangi" } },
      { "type": "tool_use", "id": "toolu_01B", "name": "cari_buku",
        "input": { "kata_kunci": "Tere Liye", "maks_hasil": 3 } }
    ]
  },
  {
    "role": "user",
    "content": [
      { "type": "tool_result", "tool_use_id": "toolu_01A",
        "content": "B-017 | Laskar Pelangi | Andrea Hirata | tersedia 2" },
      { "type": "tool_result", "tool_use_id": "toolu_01B",
        "content": "Tak ada buku yang cocok dengan 'Tere Liye'. Coba kata kunci lain.",
        "is_error": true }
    ]
  }
]
Luangkan waktu sebentar untuk membacanya, karena tiga kebiasaan penting terlihat di sini. Pertama, giliran asisten dikirim balik utuh, lengkap dengan blok tool_use-nya. Kedua, setiap tool_result menunjuk permintaan yang dijawabnya lewat tool_use_id, mirip nomor antrean. Ketiga, pencarian yang gagal tidak disembunyikan. Ia dikembalikan sebagai hasil dengan is_error: true, lengkap dengan saran, sehingga model bisa mencoba cara lain.
Tiga tempat tool berjalan
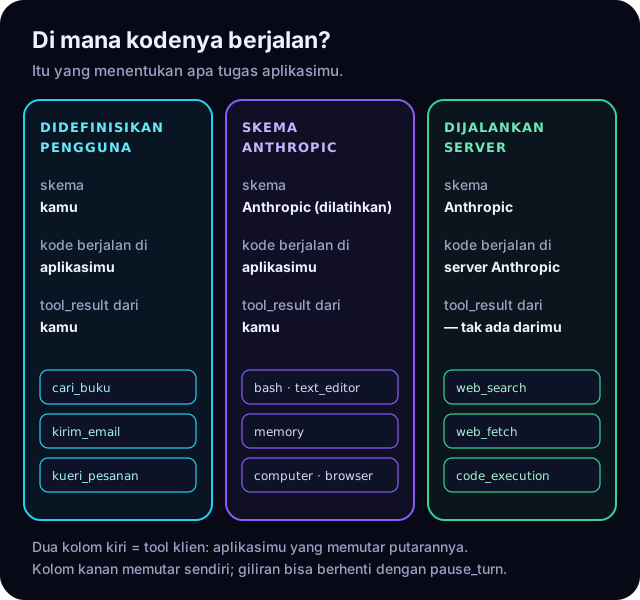
Tidak semua tool harus kamu tulis dari nol. Yang membedakan ketiganya adalah siapa yang menulis skemanya dan di mana kodenya berjalan:
| Jenis | Contoh | Tugas aplikasimu |
|---|---|---|
| Didefinisikan pengguna | logika bisnis, API internal | tulis skema, jalankan, kirim tool_result |
| Skema Anthropic, dijalankan klien | bash, text_editor, memory, computer, browser | jalankan dan kirim tool_result |
| Dijalankan server | web_search, web_fetch, code_execution, tool_search | aktifkan, lalu baca hasilnya; tak ada tool_result darimu |
Jenis kedua menarik. Skemanya ditulis Anthropic dan model sudah dilatih memakainya, sehingga pemanggilannya lebih andal, tetapi kodenya tetap berjalan di aplikasimu. Pada jenis ketiga, semuanya terjadi di server Anthropic dan kamu cukup membaca hasilnya.
Banyak permintaan dalam satu giliran
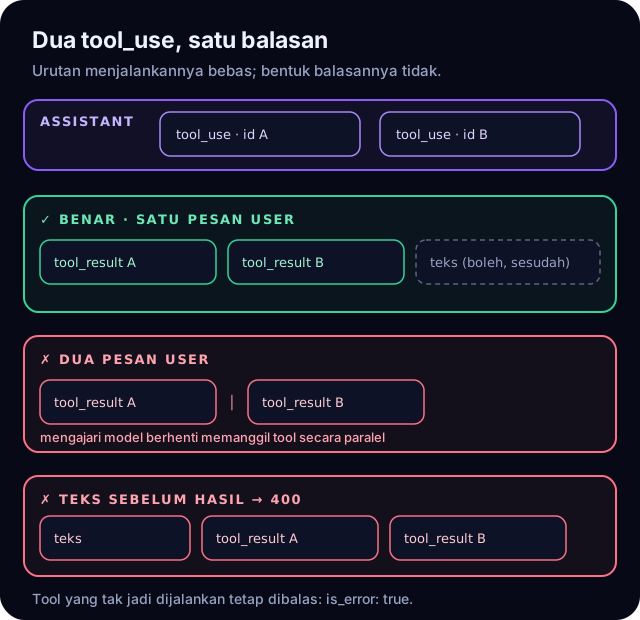
Model boleh meminta beberapa tool sekaligus, misalnya mencari dua buku dalam satu giliran. API tidak menentukan urutan menjalankannya. Tool yang hanya membaca biasanya aman dijalankan bersamaan, sedangkan tool yang mengubah sesuatu atau saling bergantung lebih baik dijalankan berurutan.
Yang mengikat justru bentuk balasannya:
- kirim satu
tool_resultuntuk setiaptool_use, semuanya dalam satu pesanuser; - taruh blok
tool_resultlebih dulu; teks sesudahnya boleh, tetapi teks sebelumnya ditolak dengan galat 400; - pesan hasil harus langsung mengikuti giliran asisten yang memintanya;
- tool yang sengaja tidak dijalankan (misalnya karena panggilan sebelumnya gagal) tetap dibalas, dengan
is_error: truedan alasan singkat.
Kenapa harus satu pesan? Menurut dokumentasi, memecah hasil ke beberapa pesan "mengajari" model untuk berhenti memanggil tool secara paralel, dan kamu kehilangan kecepatan yang sebenarnya bisa didapat.
Mengatur kapan model memanggil tool
Secara bawaan, model memutuskan sendiri kapan memakai tool. Bila perlu, kamu bisa mengarahkannya lewat tool_choice:
tool_choice | Perilaku |
|---|---|
{"type": "auto"} | model memutuskan sendiri (bawaan bila ada tools) |
{"type": "any"} | wajib memakai salah satu tool |
{"type": "tool", "name": "…"} | wajib memakai tool itu |
{"type": "none"} | dilarang memakai tool |
Ingin paling banyak satu panggilan per giliran? Tambahkan "disable_parallel_tool_use": true di dalam tool_choice.
Peringatan
Tak semua model menerima pemanggilan paksa. Claude Opus 5.5, Claude Sonnet 5.5, Claude Fable 5.1, dan Claude Mythos 5.1 menolak any dan tool dengan galat 400. Pakai auto, sebut tool-nya di instruksi, aktifkan strict: true supaya argumennya tetap terjamin, lalu periksa apakah panggilan benar-benar terjadi. Bila yang kamu butuhkan sebenarnya hanya JSON berbentuk tetap, pakai structured outputs.
Ada juga cara memastikan bentuk argumennya, yaitu strict tool use. Dengan strict: true, pilihan model dibatasi saat ia menyusun jawaban token demi token (grammar-constrained sampling), sehingga input selalu cocok dengan skema dan name selalu sah. Tak ada lagi "2" sebagai pengganti 2, atau medan wajib yang hilang. Skemanya mengikuti subset JSON Schema yang sama dengan structured outputs, termasuk additionalProperties: false.
Satu gagasan, tiga vendor
Kalau suatu saat kamu bekerja dengan OpenAI atau Gemini, kabar baiknya: gagasannya sama, hanya namanya berbeda. Tabel ini bisa jadi kamus kecilmu.
| Claude (Messages API) | OpenAI | Gemini | |
|---|---|---|---|
| definisi | name, description, input_schema | type: "function", name, description, parameters | deklarasi fungsi: name, description, parameters |
| model meminta | blok tool_use (id) | item function_call (call_id) | langkah function_call (id) |
| kamu membalas | blok tool_result (tool_use_id) di pesan user | function_call_output (call_id) | function_result (call_id) |
| paksa / larang | tool_choice: auto, any, tool, none | tool_choice: auto, required, fungsi tertentu, none | tool_choice: auto, any, none, validated |
| kepatuhan skema | strict: true | strict: true (semua medan required, additionalProperties: false) | mode validated |
| matikan paralel | disable_parallel_tool_use | parallel_tool_calls: false | tak disebut di panduannya |
Ketiganya juga sepakat soal praktik baik: deskripsi yang jelas, tipe yang ketat (pakai enum), tidak terlalu banyak tool aktif sekaligus (OpenAI menyarankan di bawah 20, Gemini 10–20), dan validasi argumen sebelum dijalankan.
Kapan memakai tool, dan kapan tidak perlu
Tool cocok untuk tindakan yang berakibat nyata (mengirim, menulis, mengubah), data yang segar atau milik sistemmu sendiri, keluaran yang bentuknya harus pasti, dan memanggil sistem yang sudah ada. Dokumentasi Claude memberi tanda yang sangat praktis: bila kamu menulis regex untuk mengambil keputusan dari teks keluaran model, keputusan itu semestinya menjadi panggilan tool.
Sebaliknya, tool tidak dibutuhkan bila model bisa menjawab dari pengetahuannya sendiri (meringkas, menerjemahkan), bila memang tak ada yang perlu dijalankan, atau bila tambahan satu putaran lebih mahal daripada pekerjaannya.
Dengar dari para pembuatnya
Kalau kamu ingin mendengar langsung dari orang-orang yang membangunnya, dua percakapan dari kanal resmi Anthropic ini layak ditonton. Keduanya direkam pada Oktober 2025, jadi beberapa nama model dan API di dalamnya lebih tua dari yang dipakai halaman ini.
Hal yang perlu diwaspadai
- Hasil tool belum tentu bisa dipercaya. Halaman web, email masuk, atau respons API pihak ketiga bisa menyelipkan instruksi untuk membelokkan model. Serangan ini disebut indirect prompt injection (injeksi prompt tidak langsung). Simpan isi seperti itu di dalam
tool_result, bukan disystematau teksuser. - Tool berarti kode yang benar-benar berjalan. Validasi setiap argumen. Untuk tool yang berakibat nyata, seperti mengirim email, mengubah data, atau membayar, mintalah persetujuan manusia lebih dulu.
- Setiap definisi tool memakan konteks. Definisi ikut masuk ke prompt dan ditagih sebagai token masukan. Tool yang tumpang tindih juga membuat model bingung memilih.
- Model bisa memilih tidak memanggil tool, atau memanggilnya dengan argumen yang keliru. Tanpa
strict, perlakukan argumen sebagai masukan yang belum divalidasi.
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: JSON, JSON Schema, dan satu panggilan API
Halaman ini mengandaikan kamu sudah akrab dengan tiga hal. Tak perlu ahli; cukup tidak kaget ketika bertemu mereka.
- JSON dan JSON Schema. JSON Schema adalah cara baku menuliskan bentuk sebuah objek JSON: medan apa saja yang ada (
properties), tipenya (type), mana yang wajib (required), pilihan yang boleh (enum), dan apakah medan lain dilarang (additionalProperties). Setiap tool dideskripsikan dengan skema seperti ini, dan argumen yang dikirim model berbentuk objek JSON. - Satu panggilan API model bahasa. Kamu pernah mengirim pesan ke model dan membaca balasannya. Satu hal yang penting diingat: API-nya stateless, artinya ia tak menyimpan ingatan di antara permintaan. Karena itu seluruh riwayat percakapan dikirim ulang setiap kali.
- Python 3.10 atau lebih baru, karena contoh kodenya memakai SDK resmi
anthropic.
Kabar baiknya, kamu tak perlu kunci API untuk mengikuti sebagian besar langkah. Putaran agennya bisa diuji dengan respons tiruan, seperti yang ditunjukkan di langkah 4.
- JSON dan JSON Schema. JSON Schema adalah cara baku menuliskan bentuk sebuah objek JSON: medan apa saja yang ada (
- 1
Pahami pembagian kerjanya: model meminta, kamu menjalankan
Satu putaran tool use, dengan nama medan Messages API Claude. Langkah dua sampai empat berulang sampai model selesai. Diringkas dari halaman How tool use works di dokumentasi resmi.Lisensi: Karya sendiri Sebelum menulis kode apa pun, pegang dulu satu gagasan ini: model tak pernah menjalankan apa pun sendiri. Coba ikuti satu putaran dari awal.
- Kamu mengirim pesan pengguna bersama daftar tool yang boleh dipakai.
- Model memutuskan butuh tool. Ia berhenti dengan
stop_reason: "tool_use"dan menyertakan bloktool_use, semacam formulir permintaan berisiid(nomor permintaan),name(tool yang diminta), daninput(argumennya). - Kamu menjalankan fungsinya di kodemu sendiri: kueri basis data, panggilan HTTP, atau menulis berkas.
- Kamu mengirim hasilnya sebagai
tool_result, dan model melanjutkan dari situ.
Model tak pernah melihat isi fungsimu. Yang ia tahu hanya deskripsi yang kamu tulis dan hasil yang kamu kembalikan, jadi dua hal itulah yang menentukan seberapa baik ia memakai tool-mu.
Tips
Coba jawab: model berhenti dengan
stop_reason: "max_tokens", dan responsnya memuat satu bloktool_use. Apakah tool-nya kamu jalankan? Jangan. Model kehabisan jatah token di tengah jalan, jadi argumennya bisa terpotong. - 2
Tulis definisi tool yang mudah dipahami model
Bagi model, definisi tool adalah satu-satunya petunjuk. Ia tak bisa membaca kodemu, jadi deskripsimu perlu menjawab hal-hal yang biasanya kamu jelaskan kepada rekan kerja baru. Ini definisi yang kita pakai di sepanjang halaman:
json { "name": "cari_buku", "description": "Mencari buku di katalog perpustakaan berdasarkan judul atau nama penulis. Pakai tool ini setiap kali pengguna menanyakan ketersediaan, penulis, atau lokasi rak sebuah buku. Hasilnya paling banyak `maks_hasil` buku, masing-masing dengan id, judul, penulis, dan jumlah eksemplar yang tersedia. Tool ini tidak meminjamkan buku.", "input_schema": { "type": "object", "properties": { "kata_kunci": { "type": "string", "description": "Judul atau nama penulis, mis. 'Laskar Pelangi' atau 'Pramoedya'." }, "maks_hasil": { "type": "integer", "description": "Jumlah hasil paling banyak, 1 sampai 10. Bawaan 5." } }, "required": ["kata_kunci"] } }Baca deskripsinya pelan-pelan. Ia menjawab empat pertanyaan: apa yang dilakukan tool ini, kapan dipakai, apa arti tiap parameter, dan apa yang tidak dilakukannya. Kalimat terakhir, "Tool ini tidak meminjamkan buku", tampak sepele, padahal justru itu yang mencegah model memakai
cari_bukuuntuk meminjam.Tiga kebiasaan kecil lainnya: pakai
enumbila pilihannya terbatas, masukkan kerequiredhanya yang benar-benar wajib, dan beri awalan nama layanan bila tool-mu banyak (github_list_prs,slack_send_message). - 3
Baca permintaan, kirim balasan: tool_use dan tool_result
Setiap blok
tool_usemembawa tiga hal yang kamu butuhkan:id,name, daninput. Balasanmu berupa pesanuseryang berisi bloktool_result, satu untuk setiap permintaan:Medan Isi tool_use_ididdari bloktool_useyang dijawabcontentteks, atau daftar blok text,image,document,search_result; boleh kosongis_errortruebila tool-nya gagalAnggap
tool_use_idseperti nomor antrean: dari situ model tahu hasil mana menjawab permintaan yang mana.Ada tiga aturan yang paling sering terlewat, dan ketiganya berujung galat:
- Pesan hasil harus langsung mengikuti giliran asisten; tak boleh ada pesan lain di antaranya.
- Di dalam pesan itu, semua
tool_resultditaruh lebih dulu. Teks tambahan hanya boleh sesudahnya. - Giliran asisten dikirim balik utuh (
response.content), bukan hanya teksnya. Tanpa bloktool_use-nya,tool_use_idtak punya pasangan.
Catatan
Bertemu galat "tool_use ids were found without tool_result blocks immediately after"? Hampir selalu penyebabnya aturan 1 atau 3.
Latihan: tulis dengan tangan balasan untuk respons yang berisi satu
textdan duatool_use, dengan salah satu tool gagal. - 4
Bangun putaran agen sendiri
Sekarang kita rangkai semuanya. Idenya sederhana: kirim pesan, lihat alasan model berhenti, jalankan tool bila diminta, kirim hasilnya, lalu ulangi. Begini wujudnya dengan SDK Python resmi:
python def tanya(pertanyaan: str) -> str: messages: list[MessageParam] = [{"role": "user", "content": pertanyaan}] while True: response = client.messages.create( model="claude-opus-5-5", max_tokens=16000, tools=TOOLS, messages=messages, ) messages.append({"role": "assistant", "content": response.content}) if response.stop_reason != "tool_use": break # end_turn, atau max_tokens / refusal yang perlu ditangani aplikasimu hasil: list[ToolResultBlockParam] = [] for blok in response.content: if blok.type != "tool_use": continue try: isi = jalankan_tool(blok.name, blok.input) hasil.append({"type": "tool_result", "tool_use_id": blok.id, "content": isi}) except Exception as galat: hasil.append({"type": "tool_result", "tool_use_id": blok.id, "content": str(galat), "is_error": True}) messages.append({"role": "user", "content": hasil}) # SEMUA hasil, satu pesan return "".join(b.text for b in response.content if b.type == "text")Perhatikan tiga hal. Giliran model disimpan utuh lewat
response.content. Semua hasil dikirim dalam satu pesan. Dan galat tidak menghentikan putaran, karena ia dikembalikan sebagai hasil ber-is_error.Tips
Kamu bisa menguji putaran ini tanpa kunci API dan tanpa biaya, seperti contoh ini diuji. Beri klien SDK
http_client=httpx2.Client(transport=httpx2.MockTransport(...))yang membalas dengan respons tiruan. SDK 1.x memakaihttpx2, fork darihttpx; transport dari pakethttpxlama tak terlihat olehnya. - 5
Kembalikan galat yang menunjukkan jalan keluar
Apa yang sebaiknya terjadi bila tool gagal, misalnya server mati atau buku tak ditemukan? Godaan pertama adalah melempar pengecualian. Jangan. Putaranmu akan berhenti, dan model tak pernah tahu apa yang salah. Lebih baik kembalikan
tool_resultdenganis_error: truedan pesan yang bisa ditindaklanjuti.Kurang membantu Membantu "failed""Rate limit exceeded. Retry after 60 seconds."jejak tumpukan Python "Tak ada buku yang cocok dengan 'Tere Liye'. Coba kata kunci lain."Kenapa isi pesannya penting? Menurut dokumentasi Claude, model biasanya mencoba 2–3 kali memperbaiki panggilan yang tak sah (misalnya parameter wajib hilang) sebelum meminta maaf kepada pengguna. Pesan galatmu adalah petunjuk perbaikannya.
Ada tiga jenis galat, masing-masing dengan penanganannya sendiri:
- Tool gagal dijalankan (jaringan putus, layanan mati): kembalikan
is_error: trueberisi penyebab dan saran. - Argumen tak sah: kembalikan
is_error: trueyang menyebut medan yang salah. Selama pengembangan, ini tanda deskripsimu perlu diperjelas.strict: truemenghapus jenis galat ini sama sekali. - Galat dari tool server (misalnya
web_search): model menanganinya sendiri, jadi tak perluis_errordarimu.
- Tool gagal dijalankan (jaringan putus, layanan mati): kembalikan
- 6
Jalankan tool paralel, balas sekaligus
Dua permintaan, satu balasan: semua tool_result dikumpulkan dalam satu pesan, di depan teks. Menurut halaman Handle tool calls dan Parallel tool use.Lisensi: Karya sendiri Kadang model meminta beberapa tool dalam satu giliran, misalnya mencari dua buku sekaligus. Kamu bebas menjalankannya bersamaan (
asyncio.gather) atau satu per satu. Pilihannya bergantung pada sifat tool-nya:- Bersamaan untuk operasi baca yang tak saling bergantung, supaya pengguna menunggu lebih singkat.
- Berurutan untuk tool yang mengubah sesuatu atau yang saling bergantung. Berhentilah di kegagalan pertama, lalu balas panggilan yang batal dijalankan dengan
is_error: true, misalnya"Not executed: the preceding write_file call failed."
Strategi apa pun yang kamu pilih, semua hasil kembali dalam satu pesan
user, urut sesuaitool_use_id. Bila model terlalu sering menggabungkan panggilan yang sebenarnya saling bergantung, dokumentasi menyarankan satu kalimat di prompt sistem: "Only batch tool calls that are independent of each other."Latihan: buat dua tool, satu membaca dan satu menulis. Kapan putaranmu boleh menjalankan keduanya bersamaan, dan kapan tidak?
- 7
Atur pemanggilan dan bentuk argumen: tool_choice dan strict
Di sini ada dua tuas yang berbeda.
tool_choicemengatur apakah model memanggil tool, sedangkanstrictmengatur bentuk argumennya. Untuk tool yang berakibat nyata, seperti meminjamkan buku, bentuk argumen yang pasti sangat berharga. Skema tool ketat wajib memakaiadditionalProperties: false:json { "name": "pinjam_buku", "description": "Meminjamkan satu buku kepada anggota. Hanya dipanggil sesudah pengguna menyetujui peminjaman secara eksplisit.", "strict": true, "input_schema": { "type": "object", "properties": { "id_buku": { "type": "string" }, "id_anggota": { "type": "string" }, "lama_hari": { "type": "integer", "enum": [7, 14] } }, "required": ["id_buku", "id_anggota", "lama_hari"], "additionalProperties": false } }Dengan
strict,lama_haridijamin berupa angka7atau14. Tak akan muncul"seminggu".Peringatan
Pada Claude Opus 5.5, Claude Sonnet 5.5, Claude Fable 5.1, dan Claude Mythos 5.1,
tool_choiceanydantoolmenghasilkan galat 400. Pakaiauto, sebut tool-nya di instruksi, lalu periksa apakah respons benar-benar memuattool_use.nonedandisable_parallel_tool_usetetap berlaku.Butuh JSON berbentuk tetap tanpa memanggil apa pun? Itu tugas structured outputs (
output_config.format), bukan tool pura-pura. - 8
Biarkan SDK memutar untukmu: Tool Runner
Setelah menulis putaran sendiri, kamu akan menghargai kabar ini: untuk kebanyakan agen, SDK bisa memutarnya untukmu. Tandai fungsi dengan
@beta_tool, dan SDK membuat skemanya dari tanda tangan fungsi beserta docstring-nya:python @beta_tool def cari_buku(kata_kunci: str, maks_hasil: int = 5) -> str: """Mencari buku di katalog perpustakaan berdasarkan judul atau nama penulis. Args: kata_kunci: Judul atau nama penulis, mis. 'Laskar Pelangi'. maks_hasil: Jumlah hasil paling banyak, 1 sampai 10. """ return "B-017 | Laskar Pelangi | Andrea Hirata | tersedia 2" runner = client.beta.messages.tool_runner( model="claude-opus-5-5", max_tokens=16000, tools=[cari_buku], messages=[{"role": "user", "content": "Apakah Laskar Pelangi ada?"}], ) for message in runner: # satu BetaMessage per giliran; berhenti saat model selesai print(message.stop_reason)Dari tanda tangan itu, SDK menyusun skema dengan
kata_kunciwajib,maks_hasilberbawaan5, danadditionalProperties: false. Ia lalu memanggil model, menjalankan fungsimu saat diminta, mengirimtool_result, dan berhenti ketika model selesai (end_turn).Tool Runner masih beta, tetapi kamu tidak kehilangan kendali. Setiap giliran bisa diperiksa sebelum tool dijalankan, untuk meminta persetujuan, mencatat, atau menolak. Kembalilah ke putaran manual hanya bila kamu butuh kendali yang tidak disediakannya.
- 9
Rancang tool untuk agen, bukan untuk programmer
Tool yang nyaman bagi programmer belum tentu nyaman bagi agen. Programmer membaca dokumentasi sekali lalu ingat; agen membaca semuanya token demi token, setiap kali. Artikel Writing effective tools for agents (Anthropic, 2025) merangkum pelajarannya:
- Sedikit tool yang cerdas, bukan bungkus setiap endpoint. Ganti
list_contactsdengansearch_contacts, dan gantilist_users+list_events+create_eventdengan satuschedule_event. Mengembalikan semua kontak hanya memboroskan konteks agen. - Pisahkan dengan awalan nama (namespace) menurut layanan dan sumber daya:
asana_projects_search,asana_users_search. - Kembalikan konteks yang bermakna. Nama dan istilah yang wajar lebih mudah dipakai model daripada UUID samar. Buang medan teknis yang tak membantu langkah berikutnya.
- Hemat token. Sediakan paginasi, filter, dan pemotongan dengan bawaan yang masuk akal; Claude Code, misalnya, membatasi respons tool 25.000 token. Parameter
response_format(conciseataudetailed) membiarkan agen memilih sendiri. - Galat yang mendidik. Pesan galat dan pemotongan bisa mengarahkan agen ke strategi yang lebih hemat, misalnya pencarian yang lebih sempit.
- Jelaskan seperti kepada pegawai baru. Tulis eksplisit hal-hal yang biasanya kamu anggap jelas: format kueri, istilah khusus, hubungan antarsumber daya. Nama parameter pun tak boleh ambigu:
user_id, bukanuser.
Latihan: ambil satu API yang kamu kenal, lalu rancang tiga tool untuk agen di atasnya, bukan satu tool per endpoint.
- Sedikit tool yang cerdas, bukan bungkus setiap endpoint. Ganti
- 10
Amankan tool-mu
Memberi model tool sama dengan memberinya tangan untuk bertindak. Karena itu, perlakukan setiap argumen tool sebagai keluaran model yang belum dipercaya, dan setiap hasil tool dari luar sebagai masukan yang bisa berbahaya.
- Validasi argumen sebelum menjalankan, bahkan bila
strictaktif. Skema menjamin bentuk, bukan izin. - Minta persetujuan manusia untuk tindakan yang berakibat nyata: mengirim, menghapus, membayar. Di putaran manual, periksa
tool_usesebelum menjalankannya; di Tool Runner, gerbangnya bisa di dalam fungsi tool atau di pemeriksaan tiap giliran. - Beri hak akses seperlunya. Tool yang hanya perlu membaca jangan diberi kredensial untuk menulis.
- Kurung jalur berkas. Ubah
pathdari model ke bentuk kanonik dan pastikan tetap di bawah direktori proyek (Path.resolve()lalu.is_relative_to(root)). Tolak.., symlink, dan jalur absolut di luarnya. - Perintah shell: izinkan hanya program yang ada di daftar (allowlist), tolak operator
&&,|,;, dan jalankan di lingkungan terisolasi dengan batas waktu. Daftar larangan (blocklist) saja tidak cukup. - Waspadai injeksi prompt tidak langsung. Halaman web atau email yang dikembalikan tool bisa berisi instruksi palsu. Biarkan isinya di dalam
tool_result, dan jangan beri tool berbahaya kepada agen yang membaca isi tak tepercaya tanpa gerbang persetujuan.
Peringatan
Parameter yang meminta model menuliskan penalarannya langkah demi langkah dapat memicu penolakan
reasoning_extraction. Mintalah penjelasan singkat atau bukti pendukung saja. - Validasi argumen sebelum menjalankan, bahkan bila
- 11
Ukur apakah tool-mu benar-benar dipakai dengan baik
Tool yang "terasa" bagus belum tentu dipakai dengan benar. Satu-satunya cara tahu adalah mengukurnya. Writing effective tools for agents menyarankan langkah-langkah ini:
- Buat banyak tugas evaluasi dari pemakaian nyata, masing-masing dengan jawaban atau hasil yang bisa diperiksa. Tugas yang kuat butuh beberapa panggilan tool: "Jadwalkan rapat dengan Jane minggu depan, lampirkan catatan rapat terakhir, dan pesan ruangan." Tugas yang lemah terlalu harfiah: "Jadwalkan rapat dengan jane@acme.corp minggu depan."
- Jalankan secara terprogram dengan putaran agen sederhana, satu putaran per tugas.
- Catat lebih dari sekadar benar atau salah: jumlah panggilan tool, token yang dipakai, waktu, dan galat tool.
- Baca transkripnya. Panggilan yang berlebihan sering menandakan perlunya paginasi atau tool yang sebaiknya digabung. Parameter yang keliru sering menandakan deskripsi yang ambigu.
- Ubah satu hal, lalu ukur lagi, dengan set uji yang tidak dipakai saat memperbaiki, supaya hasilnya tidak sekadar cocok dengan soal latihan (overfit).
Catatan
Setiap evaluasi dengan model sungguhan memakan biaya API. Uji dulu bentuk putaran dan pesan galatmu dengan respons tiruan seperti di langkah 4, lalu simpan anggaran untuk mengukur perilaku model.
Tools
SDK resmi untuk Messages API Claude di Python: tipe untuk definisi tool, blok tool_use dan tool_result, serta Tool Runner (beta) yang memutar putaran agen sendiri.
Dipakai di langkah 4 dan 8. Paket PyPI-nya bernama anthropic; versi 1.x butuh Python 3.10+ dan memakai httpx2 untuk HTTP, termasuk untuk transport tiruan saat menguji.
Implementasi JSON Schema untuk Python: memeriksa apakah sebuah skema sah dan apakah sebuah objek cocok dengannya.
Berguna untuk memeriksa input_schema dan argumen tool sebelum dijalankan, terutama untuk tool tanpa strict atau di luar Tool Runner.
Pemeriksa tipe statis untuk Python yang membaca anotasi tipe dan melaporkan ketidakcocokan sebelum kode dijalankan.
Jalankan dengan --strict terhadap tipe SDK (MessageParam, ToolParam, ToolResultBlockParam) untuk menangkap definisi tool atau pesan yang salah bentuk tanpa memanggil API.
Mini Project
Misi
Agen perpustakaan dengan tiga tool dan gerbang persetujuan
Saatnya merangkai semua yang sudah kamu pelajari. Bangun agen perpustakaan di atas putaran manual dari langkah 4, dengan tiga tool:
cari_buku,riwayat_pinjaman(id_anggota), danpinjam_buku(id_buku, id_anggota, lama_hari).Tool terakhir istimewa karena dua hal: ia ketat (
strict: true) dan berakibat nyata. Jadi sebelum menjalankannya, aplikasimu menampilkan rincian peminjaman dan menunggu pengguna setuju.Kerjakan semuanya lebih dulu tanpa kunci API, dengan transport HTTP tiruan, lalu tutup dengan satu percakapan sungguhan.
Kamu selesai bila:
- ketiga definisi tool lolos pemeriksaan skema dengan
jsonschema, dan kode putaranmu lolosmypy --strict; - pengujianmu membuktikan dua
tool_usedalam satu giliran dibalas dengan duatool_resultdalam satu pesan, urut sesuaitool_use_id; - mencari buku yang tak ada menghasilkan
is_error: truedengan saran yang bisa ditindaklanjuti, bukan pengecualian yang menghentikan putaran; - ketika pengguna menolak peminjaman, model menerima
tool_resultberisi penolakan itu, dan tak satu pun peminjaman tercatat; - respons
max_tokensyang memuattool_usetidak menjalankan tool apa pun; - setelah semuanya hijau, satu percakapan sungguhan dijalankan dan transkripnya kamu simpan.
- ketiga definisi tool lolos pemeriksaan skema dengan
Misi
Evaluasi kecil: apakah deskripsimu benar-benar membantu?
Di langkah 2 kita bilang deskripsi adalah faktor terpenting. Sekarang buktikan sendiri. Ambil agen dari proyek pertama, lalu bandingkan dua versi deskripsi
cari_buku: versi satu kalimat dan versi lengkap dari langkah 2.- Tulis sepuluh tugas realistis yang hasilnya bisa diperiksa; sedikitnya empat di antaranya butuh lebih dari satu panggilan tool.
- Sisihkan empat tugas sebagai set uji yang tak kamu sentuh saat memperbaiki. Enam sisanya untuk bereksperimen.
- Jalankan setiap tugas dengan kedua versi, lalu catat per tugas: benar atau salah, jumlah panggilan tool, token masukan dan keluaran, serta galat tool.
Kamu selesai bila:
- tabel hasil kedua versi tersedia untuk keempat tugas uji;
- setiap tugas yang gagal punya satu kalimat penyebab yang kamu ambil dari transkrip, bukan tebakan;
- satu perbaikan deskripsi diusulkan dari temuan itu, lalu diukur ulang di tugas uji yang sama;
- biaya total evaluasinya tercatat dari
usagedi setiap respons.
Resources
Dokumentasi resmi
- Tool use dengan Claude — ikhtisar resmiplatform.claude.com
- How tool use works — kontrak, tempat tool berjalan, dan putaran agenplatform.claude.com
- Define tools — skema, deskripsi, input_examples, dan tool_choiceplatform.claude.com
- Handle tool calls — tool_use, tool_result, dan is_errorplatform.claude.com
- Parallel tool use — menjalankan dan membalas panggilan paralelplatform.claude.com
- Strict tool use — grammar-constrained samplingplatform.claude.com
- Tool Runner — putaran agen yang diurus SDKplatform.claude.com
- Server tools — web search, web fetch, code execution, dan pause_turnplatform.claude.com
- Writing effective tools for agents — Anthropic Engineering (11 September 2025)anthropic.com
- Building effective agents — Anthropic Engineeringanthropic.com
- Function calling — OpenAI APIdevelopers.openai.com
- Function calling — Gemini APIai.google.dev
Video
Topik terhubung
Dibutuhkan oleh
Draf — belum diperiksa manusia
Draf — belum diperiksa manusia
Draf — belum diperiksa manusia
Draf — belum diperiksa manusia
Draf — belum diperiksa manusia