Memori Agen
- Langkah belajar
- 12
- Alat
- 3
- Proyek mini
- 2
- Sumber
- 15
Diperbarui 9 Oktober 2026
Overview
Pernahkah kamu bercerita panjang kepada chatbot, lalu keesokan harinya ia tak ingat apa-apa? Itu bukan kebetulan. Model bahasa tidak mengingat apa pun di antara panggilan: API-nya tanpa keadaan, dan yang "diingat" hanyalah isi jendela konteks saat itu. Memori agen adalah cara agen menyimpan, memilih, dan memanggil kembali informasi lintas giliran dan lintas sesi. Di dalam konteks ada memori kerja, seperti prompt, riwayat, dan hasil tool, yang terbatas dan makin kurang tepat bila terlalu penuh. Di luar konteks ada memori jangka panjang, seperti catatan berkas, profil pengguna, indeks vektor, dan log episode, yang ditulis dan diambil lewat tool. Halaman ini memakai kerangka CoALA (memori kerja, episodik, semantik, prosedural), teknik dari Anthropic (context editing, compaction, memory tool, sub-agen), dan rumus pengambilan dari Generative Agents, lengkap dengan contoh kode yang bisa kamu coba tanpa memanggil API.
Kenapa model tampak pelupa
Setiap panggilan ke model berdiri sendiri. Percakapan terasa berkesinambungan hanya karena aplikasimu mengirim ulang seluruh riwayatnya setiap kali, mirip seseorang yang setiap pagi harus membaca ulang buku hariannya dari halaman pertama sebelum bisa melanjutkan hari. Begitu sesi berakhir, atau riwayatnya terlalu panjang untuk dikirim, apa pun yang tak kamu simpan di tempat lain akan hilang.
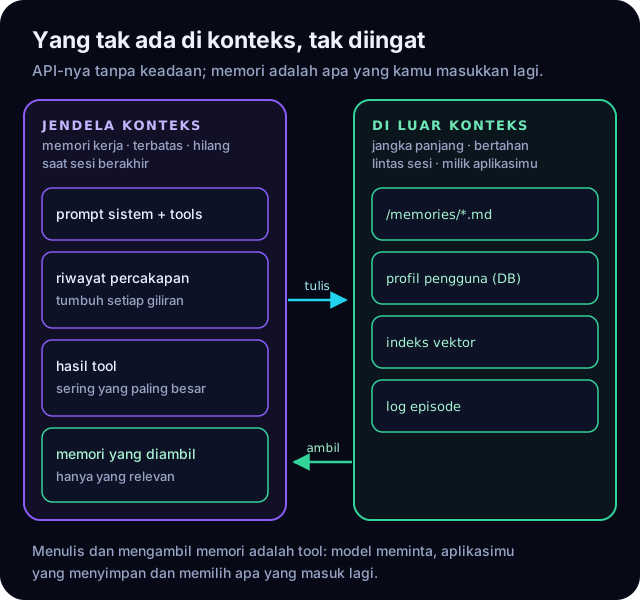
Jadi "memori agen" bukan kemampuan bawaan model, melainkan desain aplikasi. Kamulah yang memutuskan apa yang disimpan, di mana, kapan ditulis, dan apa yang dimasukkan kembali ke konteks pada giliran berikutnya.
Empat jenis memori
Supaya bisa merancang, kita butuh peta. Kerangka Cognitive Architectures for Language Agents (CoALA; Sumers dkk., 2023) meminjam istilah dari ilmu kognitif, ilmu tentang cara manusia berpikir dan mengingat, untuk memetakan memori agen bahasa:
| Jenis | Isi | Contoh pada agen |
|---|---|---|
| Kerja | informasi aktif untuk siklus keputusan saat ini: masukan, tujuan, hasil penalaran | isi konteks: prompt, riwayat, hasil tool |
| Episodik | pengalaman dari siklus sebelumnya | log percakapan lama, lintasan tugas, contoh yang berhasil |
| Semantik | pengetahuan tentang dunia dan tentang diri sendiri | fakta tentang pengguna, dokumen yang diambil lewat RAG |
| Prosedural | cara bertindak | bobot model dan kode agen; dalam praktik juga prompt sistemnya |
CoALA menegaskan bahwa memori kerja agen bahasa lebih luas daripada konteks satu panggilan: ia struktur data yang bertahan antarpanggilan. LangGraph memakai pemetaan yang sama untuk memori jangka panjangnya. Fakta tentang pengguna menjadi memori semantik, contoh few-shot (beberapa contoh yang disisipkan ke prompt) menjadi episodik, dan prompt yang diperbaiki agen sendiri menjadi prosedural.
Konteks adalah anggaran, bukan gudang
Kalau jendela konteks makin besar, kenapa tidak masukkan saja semuanya? Karena lebih banyak belum tentu lebih baik. Anthropic menyebut gejalanya context rot: makin banyak token di jendela konteks, makin turun kemampuan model mengingat informasi di dalamnya secara tepat. Ini terjadi pada semua model, hanya kecuramannya yang berbeda. Penyebabnya ada pada arsitekturnya: setiap token memperhatikan setiap token lain (n² hubungan untuk n token), dan pola atensinya dilatih dari data yang urutannya lebih sering pendek.
Dari situ lahir satu prinsip: cari himpunan token bersinyal tinggi yang sekecil mungkin untuk hasil yang diinginkan. Perlakukan konteks seperti anggaran belanja, bukan gudang tempat menumpuk barang.
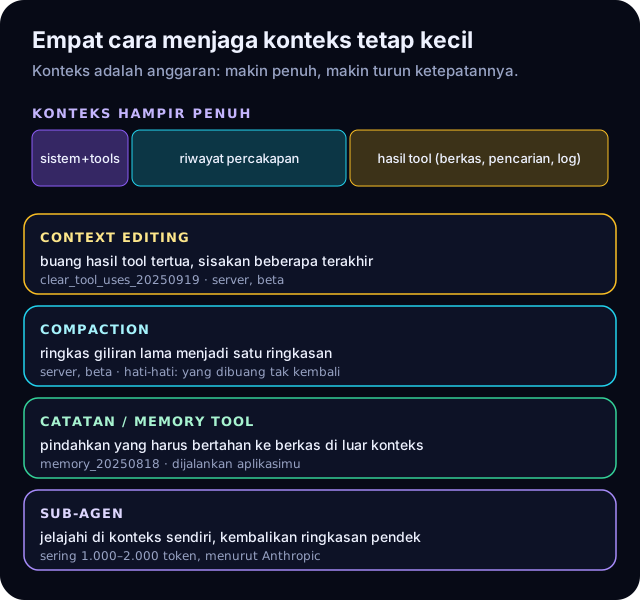
Ada lima teknik untuk menjaga anggaran itu, masing-masing cocok untuk keadaan yang berbeda:
| Teknik | Bekerja pada | Kapan dipakai |
|---|---|---|
| Context editing | hasil tool lama, blok thinking | agen yang banyak memanggil tool dan jarang perlu melihat hasil lama |
| Compaction | riwayat lama, diringkas | percakapan atau tugas panjang yang mendekati batas konteks |
| Catatan terstruktur / memory tool | hal yang harus bertahan lintas sesi | proyek berhari-hari, preferensi pengguna, kemajuan tugas |
| Pengambilan (retrieval) | penyimpanan besar di luar konteks | basis pengetahuan, riwayat panjang, banyak pengguna |
| Sub-agen | penjelajahan yang boros token | riset atau pencarian yang hasil antaranya tak perlu disimpan |
Memory tool Claude
Salah satu cara paling langsung adalah memberi agen buku catatan. Claude menyediakan tool berskema Anthropic memory_20250818: Claude meminta operasi berkas di bawah awalan /memories (view, create, str_replace, insert, delete, rename), dan aplikasimu yang menjalankannya pada penyimpanan milikmu. Dokumentasinya menyebut pola ini just-in-time: agen mencatat yang ia pelajari dan membacanya kembali saat perlu, alih-alih memuat semuanya di awal.
Begini tanggapan penangan berkas dari SDK Python resmi (BetaLocalFilesystemMemoryTool) untuk tiga permintaan, satu wajar dan dua mencoba keluar dari direktorinya:
create /memories/anggota-a9.md       → File created successfully at: /memories/anggota-a9.md
create /memories/../../rahasia.env   → Path /memories/../../rahasia.env would escape /memories directory
create /etc/passwd                   → Path must start with /memories, got: /etc/passwd
Di sesi kedua, di proses yang baru tetapi dengan penyimpanan yang sama, berkas itu dibaca kembali lengkap dengan nomor barisnya. Itulah memori lintas sesi: bukan model yang ingat, melainkan berkas yang dibaca lagi.
Peringatan
Perlindungan jalur adalah tanggung jawab penangannya, bukan model. Penangan yang hanya memeriksa awalan tanpa meresolusi jalur ke bentuk kanoniknya bisa tertipu: permintaan /memories/../../rahasia.env benar-benar menulis berkas di luar direktori memori.
Mengambil memori yang tepat
Menyimpan itu mudah; memilih apa yang dimasukkan ke konteks itulah yang sulit. Bayangkan kamu punya seribu catatan tentang seorang anggota perpustakaan. Mana yang perlu dibaca agen saat anggota itu meminta rekomendasi buku? Generative Agents (Park dkk., 2023) menjawabnya dengan memberi setiap memori skor dari tiga komponen, masing-masing dinormalisasi ke 0–1 lalu dijumlah dengan bobot sama:
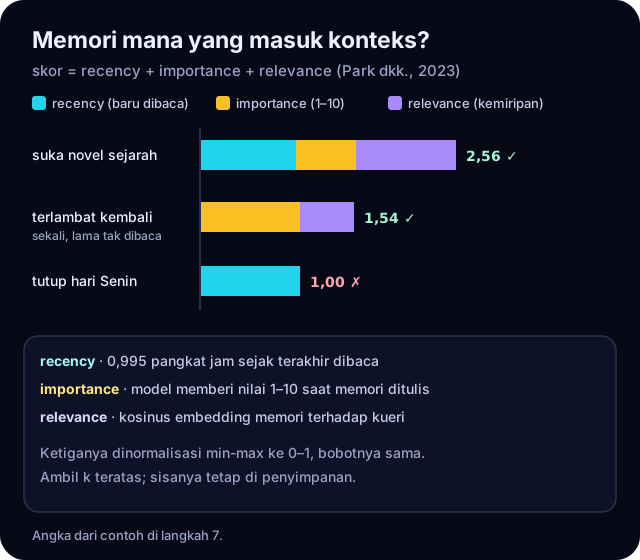
- recency (kebaruan): peluruhan eksponensial 0,995 per jam permainan sejak memori itu terakhir dibaca;
- importance (kepentingan): nilai 1–10 yang diberikan model saat memori ditulis, misalnya menyikat gigi bernilai rendah dan diterima kuliah bernilai tinggi;
- relevance (relevansi): kemiripan kosinus antara embedding memori dan embedding kueri. Embedding adalah representasi teks sebagai deretan angka, sehingga makna yang mirip punya angka yang berdekatan.
Tulisan Anthropic menambahkan dua strategi lain. Pengambilan di awal memakai embedding sebelum inferensi. Pengambilan just-in-time membuat agen menyimpan pengenal ringan (jalur berkas, kueri tersimpan, tautan) dan memuat isinya lewat tool saat dibutuhkan. Claude Code memakai keduanya: berkas CLAUDE.md dimuat di awal, sedangkan berkas lain dicari dengan glob dan grep.
Kapan menulis memori
Ada dua pilihan waktu menulis, dan LangGraph menamai keduanya dengan jelas:
- Di jalur utama: agen memutuskan mengingat sesuatu sebelum menjawab. Memorinya langsung tersedia, tetapi pengguna menunggu lebih lama dan agen harus menimbang dua hal sekaligus.
- Di latar: proses terpisah membaca percakapan lalu menulis memori. Pengguna tak perlu menunggu, tetapi memorinya baru tersedia kemudian.
Bentuk memori semantik juga perlu dipilih. Profil adalah satu dokumen yang terus diperbarui: ringkas, tetapi bisa kehilangan informasi saat ditulis ulang. Koleksi adalah banyak dokumen kecil: recall-nya, yaitu kemampuan menemukan kembali yang relevan, lebih tinggi, tetapi memperbarui dan menghapus yang usang jadi lebih rumit.
Dengar dari para pembuatnya
Dua video ini memperlihatkan memori agen dalam praktik: yang pertama demo singkat, yang kedua pembahasan desain yang lebih dalam.
Hal yang perlu diwaspadai
- Memori bisa diracuni. Isi yang ditulis dari sumber tak tepercaya, seperti halaman web atau email, bisa membawa instruksi yang dibaca lagi di sesi berikutnya. Injeksi prompt yang tersimpan bertahan jauh lebih lama daripada yang hanya lewat sekali.
- Memori berisi data pribadi. Berlakukan aturan privasi, pisahkan per pengguna, dan sediakan cara menghapus.
- Memori bisa basi atau saling bertentangan. Tanpa kedaluwarsa dan pembaruan, fakta lama tetap dipercaya. Dokumentasi memory tool menyarankan menghapus berkas yang lama tak diakses dan membatasi ukurannya.
- Ringkasan membuang detail. Compaction yang terlalu agresif bisa kehilangan konteks yang ternyata penting belakangan, dan yang sudah dibuang tak bisa kembali.
- Mengambil terlalu banyak sama buruknya dengan terlalu sedikit. Memori yang tak relevan menghabiskan anggaran konteks yang sama.
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: tool use dan cara kerja jendela konteks
Sebelum mulai, pastikan empat hal ini sudah akrab bagimu:
- Tool use, yaitu putaran
tool_use/tool_result. Topik Tool Use (Function Calling) di bidang ini adalah titik mulainya, karena menulis dan membaca memori sebenarnya adalah panggilan tool. - API tanpa keadaan: setiap permintaan membawa seluruh riwayat, dan tak ada yang diingat di sisi model.
- Token: kira-kira berapa token yang dihabiskan prompt, riwayat, dan hasil tool. Konteks diukur dalam token, bukan dalam jumlah pesan.
- Python 3.10 atau lebih baru untuk contoh kode dengan SDK resmi
anthropic.
- Tool use, yaitu putaran
- 1
Rasakan masalahnya: API tanpa keadaan
Cara terbaik memahami masalah memori adalah mengalaminya sendiri. Coba percobaan kecil ini:
- Kirim dua permintaan terpisah ke model: "Nama saya Rina.", lalu "Siapa nama saya?". Jawaban kedua tak tahu namamu, karena permintaan itu tak membawa yang pertama.
- Kirim ulang dengan riwayat lengkap. Sekarang ia "ingat".
- Hitung token riwayatnya setelah 20 giliran yang masing-masing memanggil tool berkas.
Kesimpulannya: semua "ingatan" adalah teks yang kamu kirim ulang, dan teks itu terus bertambah panjang.
Tips
Coba jawab: di mana sebuah fakta harus disimpan supaya agen masih tahu besok pagi, di proses yang berbeda? Di luar konteks, entah di berkas, basis data, atau indeks, bukan di variabel
messages. - 2
Petakan memori agenmu dengan CoALA
Teori lebih mudah dipahami bila langsung dipakai. Ambil satu agen yang sedang atau ingin kamu bangun, lalu isi tabel ini:
Jenis Di agenku disimpan di Ditulis oleh Dibaca kapan Kerja Episodik Semantik Prosedural Sebagai contoh, untuk agen perpustakaan: memori kerja adalah riwayat percakapan saat ini; episodik adalah log peminjaman yang pernah diproses; semantik adalah profil anggota (genre favorit, lama pinjaman) dan katalog; prosedural adalah prompt sistem dan kode tool-nya.
CoALA mencatat bahwa memori prosedural agen bahasa ada dua: yang tersirat di bobot model dan yang tersurat di kode agen. Mengubah bobot jarang dilakukan; mengubah kode dan prompt jauh lebih sering, dan itu juga termasuk "belajar".
- 3
Kelola memori jangka pendek
Riwayat percakapan adalah memori jangka pendek agen. Ia perlu dikelola sebelum menabrak batas konteks, dan ada tiga cara umum:
- Potong jendela: simpan N giliran terakhir saja. Murah, tetapi fakta dari awal percakapan hilang.
- Ringkas: ganti giliran lama dengan ringkasan. Intinya bertahan, tetapi detail hilang.
- Pisahkan per thread: LangGraph menyimpan memori jangka pendek per thread (satu alur percakapan) lewat checkpointer, sehingga percakapan bisa dilanjutkan dan tidak bercampur dengan percakapan lain.
Hati-hati dengan dua jebakan:
- Jangan memotong di tengah pasangan
tool_use/tool_result; keduanya wajib berpasangan dan berurutan. - Pada model dengan preserved thinking, mengedit giliran lama di sisi klien bisa membatalkan blok thinking sesudahnya. Pengelolaan konteks di sisi server, yaitu context editing dan compaction, tak membatalkannya.
Latihan: tulis fungsi yang memotong riwayat ke N giliran terakhir tanpa memisahkan pasangan tool apa pun.
- 4
Buang hasil tool lama: context editing
Hasil tool sering menjadi bagian terbesar konteks, padahal jarang dibutuhkan lagi setelah diproses, seperti tumpukan fotokopi yang sudah dibaca di meja kerja. Strategi
clear_tool_uses_20250919merapikannya di sisi server: begitu ambangnya terlampaui, hasil tool tertua dibuang. Begini cara mengaktifkannya:python response = client.beta.messages.create( model="claude-opus-5-5", max_tokens=16000, betas=["context-management-2025-06-27"], tools=[{"type": "memory_20250818", "name": "memory"}], context_management={ "edits": [ { "type": "clear_tool_uses_20250919", "trigger": {"type": "input_tokens", "value": 30000}, "keep": {"type": "tool_uses", "value": 3}, "clear_at_least": {"type": "input_tokens", "value": 5000}, "exclude_tools": ["memory"], # hasil memory tool tak pernah dibuang } ] }, messages=messages, )Opsi Bawaan Arti trigger100.000 token masukan kapan mulai membersihkan keep3 pemakaian tool berapa pasangan terbaru yang dipertahankan clear_at_least— minimal token yang dibuang; mencegah merusak prompt cache demi penghematan kecil exclude_tools— tool yang hasilnya tak pernah dibuang Aplikasimu tetap menyimpan riwayat utuh. Pemangkasan terjadi sebelum prompt sampai ke model, dan respons melaporkannya di
context_management.applied_edits. - 5
Ringkas di server: compaction
Bila yang membengkak adalah percakapan itu sendiri, bukan hasil tool, compaction mengganti giliran lama dengan ringkasan yang ditulis Claude di server. Dokumentasi Claude menempatkannya sebagai strategi utama untuk percakapan panjang. Ada dua cara memakainya, dan keduanya masih beta:
Compaction sesuai permintaan Compaction pada ambang token siapa memutuskan kapan kamu, dengan mengirim permintaan API, saat token masukan mencapai ambangmu kode yang kamu tulis putaran yang meminta ringkasan lalu menukarnya satu parameter di permintaan biasa giliran terbaru tetap utuh ya ya, dengan jeda sesudah compaction Seni compaction ada pada memilih apa yang dibuang. Saran Anthropic bagi yang menulis peringkas sendiri: maksimalkan recall lebih dulu, yaitu pastikan semua yang relevan tertangkap, baru tingkatkan presisi. Claude Code, misalnya, mempertahankan keputusan arsitektur, bug yang belum terselesaikan, dan detail implementasi, lalu melanjutkan dengan ringkasan itu ditambah lima berkas yang terakhir diakses.
Catatan
Compaction dan memory tool saling melengkapi: compaction menjaga konteks aktif tetap kecil, memory tool menyimpan yang harus selamat dari peringkasan.
- 6
Catatan terstruktur dengan memory tool
Cara paling sederhana dengan SDK Python:
BetaLocalFilesystemMemoryToolmenyimpan berkas di disk, dan Tool Runner memutar putarannya untukmu:python memori = BetaLocalFilesystemMemoryTool(base_path="./data-memori") # berkas di ./data-memori/memories runner = client.beta.messages.tool_runner( model="claude-opus-5-5", max_tokens=16000, tools=[memori], messages=[{"role": "user", "content": "Ingat: saya suka novel sejarah dan selalu meminjam 14 hari."}], ) akhir = runner.until_done()Definisi tool-nya cukup
{"type": "memory_20250818", "name": "memory"}, tanpa skema, karena skemanya milik Anthropic dan modelnya sudah dilatih memakainya.Coba jalankan dua kali di dua proses berbeda. Sesi pertama menulis
/memories/anggota-a9.md; sesi kedua membacanya kembali, lengkap dengan nomor baris selebar enam karakter dan tab, sesuai dokumentasi.Untuk proyek yang berlangsung berhari-hari, dokumentasi memory tool menyarankan pola multisesi. Sesi pertama menyiapkan log kemajuan dan daftar fitur. Setiap sesi berikutnya membacanya lebih dulu, dan setiap sesi berakhir dengan memperbarui log. Tandai fitur selesai hanya setelah diverifikasi dari ujung ke ujung.
- 7
Ambil memori yang tepat: recency, importance, relevance
Rumus Generative Agents ternyata cukup ringkas untuk ditulis dalam Python murni:
python def ambil(memori: list[dict], kueri: list[float], jam_sekarang: float, k: int = 2) -> list[str]: recency = normal([0.995 ** (jam_sekarang - m["jam_terakhir_dibaca"]) for m in memori]) importance = normal([m["penting"] for m in memori]) # 1..10, dinilai model relevance = normal([kosinus(m["vektor"], kueri) for m in memori]) skor = [r + i + v for r, i, v in zip(recency, importance, relevance)] urut = sorted(range(len(memori)), key=lambda n: skor[n], reverse=True) return [f"{skor[n]:.2f} {memori[n]['teks']}" for n in urut[:k]]normal()adalah normalisasi min-max ke 0–1, dankosinus()menghitung kemiripan kosinus. Dengan tiga memori contoh dan kueri tentang selera baca anggota, keluarannya:2.56 Anggota A-9 suka novel sejarah 1.54 Anggota A-9 terlambat mengembalikan buku sekali"Perpustakaan tutup hari Senin" (1,00) tak terambil walaupun paling baru dibaca, karena ia tak penting dan tak relevan dengan kuerinya. Di sini terlihat bagaimana tiga komponen saling menyeimbangkan.
Latihan: ubah bobot relevance menjadi 2 dan lihat urutan mana yang berubah. Bobot yang sama hanyalah pilihan makalahnya, bukan hukum.
- 8
Putuskan kapan dan dalam bentuk apa memori ditulis
Dua keputusan desain ini paling sering keliru, padahal akibatnya terasa lama.
Kapan menulis. Di jalur utama, agen menulis sebelum menjawab: memorinya segera tersedia, tetapi pengguna menunggu lebih lama dan agen menanggung beban keputusan tambahan. Di latar, proses terpisah menulis memori dari percakapan yang sudah lewat: tak ada penantian, tetapi memorinya datang terlambat.
Bentuk memori semantik.
Bentuk Kelebihan Risiko Profil (satu dokumen) ringkas, mudah dimasukkan utuh ke konteks informasi hilang saat ditulis ulang Koleksi (banyak dokumen kecil) recall lebih tinggi memperbarui dan menghapus yang usang lebih sulit; pencarian jadi wajib Untuk memori episodik, bentuk yang paling praktis adalah contoh few-shot: simpan contoh tugas yang berhasil, lalu ambil yang paling mirip dengan masukan saat ini.
Latihan: untuk agen perpustakaan, putuskan apakah preferensi anggota disimpan sebagai profil atau koleksi, dan tulis alasanmu dalam dua kalimat.
- 9
Lindungi konteks dengan sub-agen
Sub-agen adalah teknik memori yang sering terlupa. Bayangkan seorang manajer yang mengutus asisten membaca seratus dokumen, lalu hanya menerima ringkasan satu halaman. Begitu pula di sini: alih-alih menyimpan semua hasil penjelajahan di konteksnya sendiri, agen utama mengirim tugas terfokus ke sub-agen yang punya konteks bersih. Menurut Anthropic, setiap sub-agen boleh memakai puluhan ribu token untuk menjelajah, tetapi hanya mengembalikan ringkasan padat, sering 1.000 sampai 2.000 token.
Sub-agen layak dipakai untuk:
- riset yang membaca banyak sumber tetapi hanya butuh kesimpulannya;
- pencarian di basis kode besar;
- tugas paralel yang hasil antaranya tak berguna bagi agen utama.
Sebaliknya, jangan pakai sub-agen untuk tugas yang membutuhkan semua detail penjelajahan di satu tempat, atau yang sub-tugasnya saling bergantung erat. Setiap sub-agen menambah biaya, dan menambah satu titik tempat informasi bisa hilang saat diringkas.
Latihan: rancang satu tugas untuk agen perpustakaan yang layak didelegasikan ke sub-agen, dan tentukan format ringkasan yang harus dikembalikannya.
- 10
Amankan memori
Memori ditulis berdasarkan permintaan model, jadi perlakukan setiap operasinya sebagai masukan yang belum dipercaya.
- Kurung jalur. Setiap jalur harus diawali
/memories, diresolusi ke bentuk kanonik, dan tetap di bawah direktori memori. Penangan bawaan SDK (BetaLocalFilesystemMemoryTool) menolak../../,..\..\gaya Windows, dan/etc/passwd.%2e%2e%2ftidak didekode, sehingga hanya menjadi nama berkas aneh di dalam direktori memori. - Pisahkan per pengguna. Awalan
/memoriesdipetakan ke direktori atau kunci milik satu pengguna, bukan direktori bersama. - Saring data sensitif. Model biasanya menolak menulis rahasia, tetapi validasi di penangan memberi jaminan yang lebih kuat.
- Batasi ukuran dan umur. Batasi besar berkas dan keluaran
view; hapus berkas yang lama tak diakses. - Waspadai keracunan memori. Isi dari halaman web atau email yang ditulis ke memori akan dibaca lagi di sesi berikutnya. Tandai asalnya, dan jangan menulis instruksi dari sumber tak tepercaya sebagai memori prosedural.
Peringatan
Penangan buatan sendiri dengan validasi naif, yang tak meresolusi jalur, bisa tertipu menulis
rahasia.envdi luar direktori memori. Sebelum memakai penangan sendiri, ujilah dengan serangan seperti ini. - Kurung jalur. Setiap jalur harus diawali
- 11
Ukur memori agenmu
Memori yang tak pernah diukur cenderung tumbuh liar. Lima uji ini memberitahumu apakah memori agenmu benar-benar bekerja:
- Recall lintas sesi. Tanamkan fakta di sesi 1, lalu tanyakan di sesi 2 di proses baru. Berapa persen yang benar?
- Fakta yang berubah. Ubah preferensi di sesi 3. Apakah sesi 4 memakai yang baru, atau memori lama dan baru saling bertentangan?
- Pengambilan. Untuk sekumpulan kueri dengan jawaban yang diketahui, apakah memori yang benar masuk k teratas?
- Biaya. Berapa token per giliran untuk memori yang dimasukkan, dan berapa yang dihemat context editing atau compaction (
usage,context_management.applied_edits)? - Keamanan. Uji serangan jalur dan isi beracun setiap kali penangannya berubah.
Kabar baiknya, uji 1, 3, dan 5 bisa berjalan tanpa model sungguhan, karena penyimpanan, pengambilan, dan penangannya adalah kode biasa. Simpan anggaran API untuk uji 2 dan 4, yang memang bergantung pada perilaku model.
Tools
SDK resmi untuk Messages API Claude di Python: tipe untuk definisi tool, blok tool_use dan tool_result, serta Tool Runner (beta) yang memutar putaran agen sendiri.
Dipakai di langkah 4 dan 6: context editing lewat client.beta.messages.create, dan BetaLocalFilesystemMemoryTool sebagai penangan memory tool berbasis berkas.
Kerangka kerja sumber terbuka untuk agen berbentuk graf, dengan memori jangka pendek per thread lewat checkpointer dan memori jangka panjang per namespace lewat store.
Dipakai sebagai pembanding desain di langkah 3 dan 8: thread versus namespace, menulis di jalur utama versus di latar, profil versus koleksi.
Platform sumber terbuka untuk agen berkeadaan dengan memori yang bisa disunting agen sendiri, dikembangkan oleh para penulis MemGPT.
Dipakai untuk melihat gagasan MemGPT dalam praktik: memori di dalam dan di luar konteks yang dikelola agen lewat tool.
Mini Project
Misi
Agen perpustakaan yang mengingat anggota
Saatnya agen perpustakaanmu punya ingatan. Lanjutkan agen dari proyek Tool use: tambahkan memory tool dengan penyimpanan per anggota, lalu pasang context editing.
- Setiap anggota punya direktori memori sendiri;
/memoriesdipetakan ke direktori itu. - Agen mencatat preferensi (genre, lama pinjaman) dan membacanya di awal setiap sesi.
- Context editing membuang hasil
cari_bukulama, tetapi tak pernah membuang hasil memory tool.
Kamu selesai bila:
- uji dengan transport tiruan membuktikan sesi kedua (proses baru) membaca preferensi yang ditulis sesi pertama;
- memori anggota A tak pernah terbaca di sesi anggota B, dibuktikan dengan uji;
../../,..\..\, jalur absolut, dan jalur ke direktori anggota lain semuanya ditolak denganis_error: true, dan uji membuktikan tak ada berkas yang tercipta di luar direktori yang benar;- berkas memori yang lebih besar dari batas yang kamu tetapkan ditolak;
- permintaan memuat
context_managementdenganexclude_toolsberisimemory, dibuktikan dari badan permintaan yang direkam; - satu percakapan sungguhan dijalankan di akhir dan transkripnya kamu simpan.
- Setiap anggota punya direktori memori sendiri;
Misi
Aliran memori episodik dengan pengambilan berskor
Proyek kedua mengajakmu menguji rumus langkah 7 pada data yang lebih besar. Bangun penyimpanan episodik untuk agen: setiap kejadian (peminjaman, pengembalian, keluhan) disimpan sebagai memori dengan waktu, nilai penting 1–10, dan embedding.
- Ambil k memori teratas dengan skor recency + importance + relevance (langkah 7).
- Embedding boleh dari model lokal gratis atau dari API, tetapi tuliskan pilihan dan biayanya.
Kamu selesai bila:
- ada sedikitnya 50 memori dan 10 kueri dengan memori benar yang diketahui;
- kamu melaporkan recall@3 untuk tiga konfigurasi: hanya relevance, bobot sama, dan bobot pilihanmu;
- satu kasus kegagalan dijelaskan dari angka komponennya, misalnya memori yang sangat baru mengalahkan yang lebih relevan;
- memori yang tak pernah terambil selama 30 hari simulasi ditandai untuk dihapus, dan jumlahnya dilaporkan.
Resources
Dokumentasi resmi
- Memory tool — dokumentasi resmi Claudeplatform.claude.com
- Context editing — membuang hasil tool dan blok thinking lamaplatform.claude.com
- Compaction — ringkasan percakapan di serverplatform.claude.com
- Context windows — cara kerja jendela konteksplatform.claude.com
- Effective context engineering for AI agents — Anthropic Engineering (29 September 2025)anthropic.com
- Effective harnesses for long-running agents — Anthropic Engineeringanthropic.com
- Konsep memori LangGraph — jangka pendek dan jangka panjangdocs.langchain.com
Video
Paper
Topik terhubung
Pelajari lebih dulu
Draf — belum diperiksa manusia