Bagaimana kamu tahu agenmu benar-benar bekerja, dan tetap bekerja sesudah prompt, tool, atau modelnya diganti? Mencobanya beberapa kali lalu merasa "sepertinya sudah bagus" tidak cukup. Agen bekerja dalam banyak giliran, mengubah keadaan di dunia nyata, dan hasilnya bisa berbeda setiap kali dijalankan. Evals adalah ujian otomatis untuk agen: sekumpulan tugas dengan kriteria lulus yang jelas, dijalankan berkali-kali di lingkungan yang bersih, lalu dinilai oleh kode, oleh model lain, atau oleh manusia. Observability adalah kotak hitamnya: jejak yang merekam setiap panggilan model dan tool, sehingga kegagalan di produksi bisa dibaca, bukan ditebak. Di halaman ini kamu membangun keduanya untuk agen perpustakaan dari topik Tool use: harness eval kecil, penilai berbasis kode dan LLM-as-judge yang dikalibrasi, metrik pass@k dan pass^k, galat baku, jejak OpenTelemetry yang mengikuti konvensi semantik GenAI, lalu kerangka Inspect. Semua contohnya bisa kamu jalankan tanpa memanggil API berbayar.
Ujian SIM dan kotak hitam
Sebelum seseorang boleh menyetir sendiri, ia diuji dulu: rute yang sama, penguji yang sama, kriteria lulus yang sama untuk semua orang. Begitu ia di jalan, ujian itu tak lagi menolong. Yang menolong adalah kotak hitam, perekam yang mencatat setiap perjalanan, supaya ketika ada yang salah kita bisa melihat apa yang sebenarnya terjadi, bukan menebak.
Agen AI butuh keduanya. Evals adalah ujian sebelum agen dilepas dan setiap kali ia diubah. Observability adalah kotak hitamnya di produksi. Tanpa yang pertama, setiap perubahan prompt adalah tebakan. Tanpa yang kedua, keluhan pengguna hanya bisa kamu jawab dengan "di mesin saya baik-baik saja".
Kenapa agen lebih sulit diuji daripada program biasa? Program biasa umumnya memberi keluaran yang sama untuk masukan yang sama, jadi satu uji unit sering sudah cukup. Agen bekerja dalam banyak giliran: ia memanggil tool, mengubah keadaan, lalu menyesuaikan langkah berdasarkan hasil antaranya. Kesalahan kecil di giliran kedua bisa merambat sampai akhir, dan jawaban model bisa berbeda setiap kali dijalankan. Agen yang pintar bahkan bisa menemukan jalan yang tak kamu bayangkan. Anthropic menceritakan Claude Opus 4.5 yang, dalam sebuah soal pemesanan penerbangan di τ2-bench, menemukan celah di kebijakan maskapai. Menurut eval yang tertulis ia "gagal", padahal solusinya lebih baik untuk penggunanya.
Kosakata yang perlu kamu pegang
Tulisan Demystifying evals for AI agents dari tim Engineering Anthropic (9 Januari 2026) memberi kosakata yang dipakai di seluruh halaman ini:
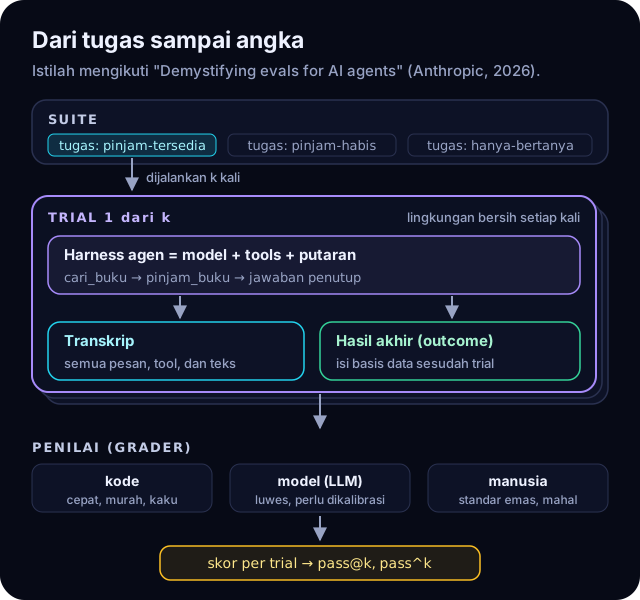
Kosakata eval agen menurut tulisan Demystifying evals for AI agents (Anthropic, Januari 2026).Lisensi: Karya sendiri
Tugas (task): satu soal dengan masukan dan kriteria sukses yang jelas.
Trial: satu kali percobaan mengerjakan tugas. Karena hasil model berbeda antarpercobaan, satu tugas dijalankan berkali-kali.
Penilai (grader): logika yang memberi skor pada satu aspek kinerja agen. Satu tugas boleh punya beberapa penilai, dan setiap penilai boleh berisi beberapa pemeriksaan.
Transkrip (juga disebut trace atau trajectory): catatan lengkap satu trial, berisi keluaran, panggilan tool, penalaran, dan hasil antara. Untuk Messages API Claude, transkrip adalah seluruh larik messages di akhir trial.
Hasil akhir (outcome): keadaan lingkungan sesudah trial. Agen pemesanan tiket boleh menulis "Tiketmu sudah dipesan", tetapi hasil akhirnya adalah ada atau tidaknya pesanan itu di basis data.
Harness eval: infrastruktur yang menjalankan semuanya, mulai dari memberi instruksi dan tool, menjalankan tugas, merekam setiap langkah, menilai, sampai merangkum hasilnya.
Harness agen (scaffold): sistem yang membuat model bisa bertindak sebagai agen. Saat kamu mengevaluasi "sebuah agen", yang kamu nilai adalah harness agen dan modelnya, bersama-sama.
Suite: kumpulan tugas dengan tujuan yang sama, misalnya semua tugas peminjaman buku.
Tiga jenis penilai
Siapa yang memberi nilai? Ada tiga pilihan, dan eval yang baik biasanya memadukannya:
luwes, menangkap nuansa, cocok untuk jawaban terbuka
tak menentu, lebih mahal, harus dikalibrasi dengan manusia
Manusia
tinjauan ahli, sampel acak, uji A/B
standar emas, sesuai penilaian pengguna ahli
mahal dan lambat
Dokumentasi Claude memberi urutan prioritas yang mudah diingat: pakai penilaian berbasis kode bila bisa, karena paling cepat dan andal; pakai LLM bila butuh penilaian yang lebih luwes, setelah keandalannya diuji; dan simpan penilaian manusia untuk yang benar-benar perlu.
Eval kemampuan dan eval regresi
Ada dua pertanyaan berbeda yang bisa diajukan sebuah suite. Eval kemampuan bertanya, "Apa yang sudah bisa dikerjakan agen ini dengan baik?" Ia sengaja dimulai dari tingkat lulus yang rendah, berisi tugas yang masih sulit, supaya tim punya bukit untuk didaki. Eval regresi bertanya, "Apakah agen masih bisa mengerjakan semua yang dulu bisa?" Tingkat lulusnya harus mendekati 100%, sehingga setiap penurunan berarti ada yang rusak.
Keduanya saling mengisi. Ketika tugas di suite kemampuan sudah lulus dengan stabil, ia boleh "naik kelas" menjadi bagian suite regresi yang dijalankan terus-menerus.
Satu agen, dua cerita
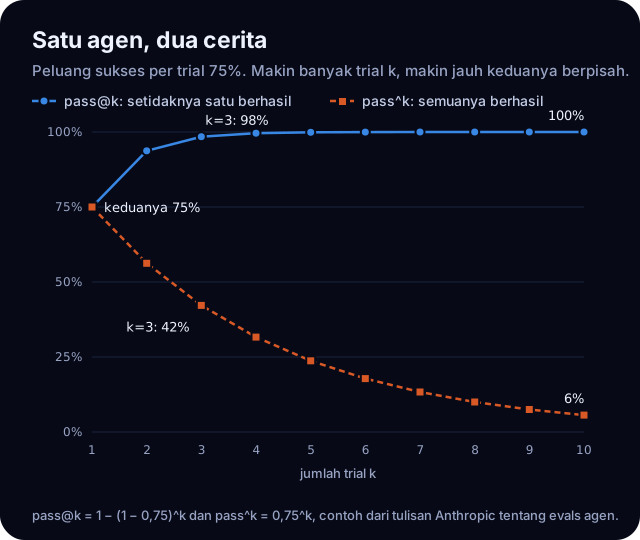
Karena hasil agen berubah-ubah, satu angka "lulus atau tidak" menyembunyikan banyak hal. Dua metrik membantu menceritakannya dengan jujur. pass@k adalah peluang setidaknya satu dari k percobaan berhasil, cocok untuk alat yang boleh mencoba beberapa kali asal satu berhasil. pass^k (dibaca pass hat k) adalah peluang semua k percobaan berhasil, cocok untuk agen yang berhadapan dengan pelanggan, yang diharapkan benar setiap kali.
pass@k = 1 − (1 − p)^k dan pass^k = p^k untuk p = 0,75, contoh dari tulisan Anthropic.Lisensi: Karya sendiri
Bayangkan agen yang berhasil 75% per trial. Pada k = 1 keduanya sama, 75%. Dengan tiga percobaan, peluang semuanya berhasil tinggal 0,75³ ≈ 42%, sedangkan peluang setidaknya satu berhasil naik ke sekitar 98%. Agen yang sama bisa tampak hampir sempurna atau sangat rapuh, tergantung pertanyaan mana yang kamu ajukan. Pilih metrik yang sesuai dengan janji produkmu.
Observability: membaca apa yang benar-benar terjadi
Eval berjalan di lingkungan buatanmu. Pengguna sungguhan hampir selalu menemukan hal yang tak terpikirkan. Di sinilah observability masuk: setiap permintaan meninggalkan satu jejak (trace), yaitu pohon span. Setiap span adalah satu operasi bernama, dengan waktu mulai, waktu selesai, dan atribut. Untuk agen, span-nya adalah panggilan agen, setiap panggilan model, dan setiap panggilan tool.
Begini jejak satu permintaan peminjaman yang berhasil, direkam dari agen perpustakaan dengan OpenTelemetry (cara memasangnya ada di langkah 9). Setiap baris adalah satu span, dan indentasinya menunjukkan span induknya:
Dari pohon kecil ini kamu sudah bisa membaca banyak hal: model dipanggil tiga kali, tool dua kali, berapa token yang dipakai setiap giliran, dan kenapa setiap giliran berhenti.
Supaya jejak dari kerangka yang berbeda bisa dibaca oleh alat yang sama, OpenTelemetry, standar terbuka untuk telemetri, punya konvensi semantik GenAI: nama span dan atribut gen_ai.* yang disepakati, misalnya invoke_agent, chat, dan execute_tool. Statusnya masih Development, artinya masih boleh berubah. Konvensi ini juga belum lama pindah ke repositorinya sendiri, semantic-conventions-genai, dan halaman lamanya di repositori konvensi utama kini hanya berisi pemberitahuan pindah. Itu pengingat yang baik: di bidang yang bergerak secepat ini, selalu baca sumber yang terbaru.
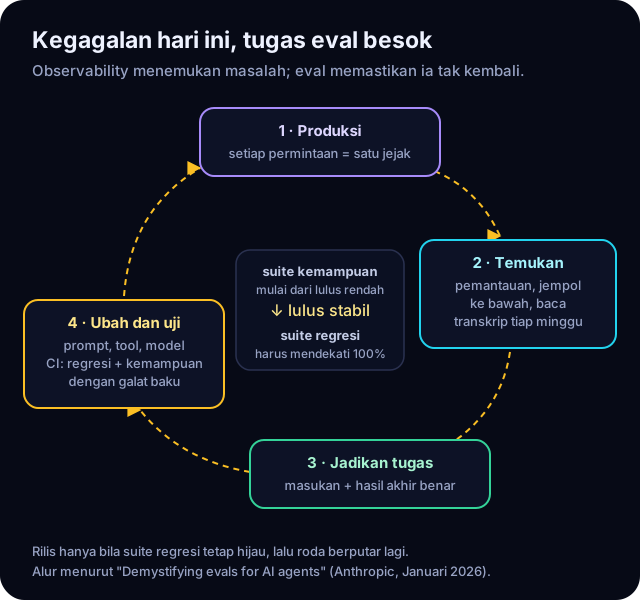
Jejak tidak berhenti di layar. Ia adalah bahan baku eval berikutnya:
Jejak produksi adalah bahan baku tugas eval berikutnya.Lisensi: Karya sendiri
Tak ada satu cara yang menangkap semua masalah. Tulisan Anthropic meminjam Swiss cheese model dari rekayasa keselamatan: setiap lapisan punya lubang, tetapi lubangnya jarang sejajar, jadi kegagalan yang lolos dari satu lapisan ditangkap lapisan lain.
Cara
Paling berguna untuk
Eval otomatis
sebelum rilis dan di CI, setiap kali agen atau model berubah
Pemantauan produksi
sesudah rilis: pola pemakaian yang bergeser dan kegagalan nyata
Uji A/B
memastikan perubahan besar saat lalu lintas sudah cukup
Umpan balik pengguna
masalah yang tak kamu duga, lengkap dengan contoh nyata
Membaca transkrip
membangun intuisi tentang cara agen gagal; lakukan rutin, misalnya tiap minggu
Studi manusia terstruktur
mengkalibrasi hakim LLM dan menilai keluaran yang subjektif
Langkah-langkah di bawah membawamu dari nol: menentukan arti berhasil, menulis tugas, membangun harness, memilih penilai, menghitung metrik dengan jujur, memasang jejak, sampai merawat suite dalam jangka panjang. Contoh kodenya memakai SDK resmi anthropic dan bisa dijalankan tanpa kunci API, dengan model tiruan yang kamu pasang lewat transport HTTP, seperti di topik Tool use.
02
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: putaran agen dan statistik dasar
Sebelum mulai, pastikan tiga hal ini sudah akrab bagimu:
Putaran agen dari topik Tool use: blok tool_use dan tool_result, serta stop_reason yang mengemudikan putaran. Agen yang kita uji di halaman ini adalah agen perpustakaan dari topik itu, dengan tool cari_buku dan pinjam_buku.
Python 3.10 atau lebih baru, termasuk dataclass, dan sedikit async untuk contoh Inspect di langkah 12.
Statistik dasar: rata-rata dan simpangan baku. Galat baku dan interval kepercayaan dijelaskan pelan-pelan di langkah 8.
Tak perlu kunci API. Semua contoh bisa dijalankan dengan model tiruan, dan kamu baru butuh kunci ketika ingin mencoba model sungguhan.
1
Tentukan dulu seperti apa "berhasil" itu
Eval yang baik dimulai jauh sebelum kode. Kalau kamu tak bisa menuliskan arti berhasil, kamu juga tak bisa mengukurnya. Dokumentasi Claude memberi empat syarat untuk kriteria sukses: spesifik, terukur, bisa dicapai, dan relevan dengan kebutuhan penggunanya.
Bandingkan dua kalimat ini. "Agen harus aman" tak bisa diuji. "Kurang dari 0,1% keluaran dari 10.000 trial ditandai beracun oleh penyaring konten" bisa diuji, dan contoh itu diambil dari dokumentasinya sendiri.
Untuk agen, kriteria terbaik biasanya ditulis sebagai keadaan akhir. Agen perpustakaan kita, misalnya:
bila anggota meminta buku yang tersedia, tepat satu peminjaman tercatat dengan id buku, id anggota, dan lama hari yang diminta, dan stoknya berkurang satu;
bila bukunya habis, tak ada peminjaman sama sekali, termasuk buku "pengganti" yang tak diminta;
bila anggota hanya bertanya, tak ada yang berubah di basis data.
Kriteria sering punya beberapa dimensi. Untuk agen layanan pelanggan, tulisan Anthropic memberi contoh tiga sekaligus: tiketnya selesai (cek keadaan), selesai dalam kurang dari 10 giliran (cek transkrip), dan nadanya pantas (rubrik).
Tips
Menulis kriteria juga menguji spesifikasimu. Dua insinyur yang membaca spesifikasi yang sama bisa menafsirkan kasus tepinya secara berbeda. Suite eval memaksa kalian sepakat.
2
Kumpulkan tugas dari kegagalan nyata
Banyak tim menunda eval karena mengira butuh ratusan tugas. Menurut Anthropic, 20 sampai 50 tugas sederhana yang diambil dari kegagalan nyata sudah awal yang bagus. Di awal pengembangan, setiap perubahan biasanya berdampak besar, jadi sampel kecil pun cukup untuk melihatnya.
Dari mana tugasnya? Mulai dari yang sudah kamu cek dengan tangan sebelum setiap rilis, lalu dari pelacak bug dan antrean dukungan pelanggan. Inilah suite pertama agen perpustakaan:
python
@dataclass
class Tugas:
    id: str
    permintaan: str
    pinjaman_diharapkan: list[dict[str, Any]]  # keadaan AKHIR yang benar


TUGAS = [
    Tugas("pinjam-tersedia", "Saya anggota A-9. Tolong pinjamkan Laskar Pelangi selama 7 hari.",
          [{"id_buku": "B-017", "id_anggota": "A-9", "lama_hari": 7}]),
    Tugas("pinjam-habis", "Saya anggota A-9. Tolong pinjamkan Bumi Manusia.", []),
    Tugas("hanya-bertanya", "Laskar Pelangi itu karya siapa?", []),
]
Perhatikan tiga hal. Pertama, setiap tugas menyimpan keadaan akhir yang benar, bukan kalimat jawaban yang diharapkan. Kedua, suite ini seimbang: dua dari tiga tugas memeriksa bahwa agen tidak meminjamkan apa pun. Eval yang hanya menguji satu arah mendorong perbaikan satu arah pula: agen yang meminjamkan apa saja akan tampak hebat. Tim web search Claude.ai mengalami hal serupa, sehingga mereka menguji dua arah sekaligus: kueri yang memang perlu dicari dan kueri yang cukup dijawab dari pengetahuan.
Ketiga, tugas yang baik adalah tugas yang membuat dua ahli sampai pada vonis lulus atau gagal yang sama. Buat juga solusi rujukan yang pasti lulus semua penilai, supaya terbukti tugasnya bisa diselesaikan. Bila model yang kuat mendapat 0% bahkan setelah 100 trial, yang paling sering rusak adalah tugas atau penilainya, bukan agennya.
3
Jalankan setiap trial di lingkungan yang bersih
Harness eval adalah mesin ujiannya: ia menjalankan setiap tugas beberapa kali, menyimpan transkripnya, lalu menilai. Syarat terpentingnya terdengar sepele, yaitu setiap trial dimulai dari lingkungan yang bersih:
python
def jalankan_suite(client: anthropic.Anthropic, k: int, berkas: str) -> dict[str, list[bool]]:
    lulus: dict[str, list[bool]] = {}
    with open(berkas, "w", encoding="utf-8") as log:
        for tugas in TUGAS:
            for trial in range(k):
                env = perpustakaan_baru()  # lingkungan bersih: tak ada sisa trial lain
                transkrip = jalankan_agen(client, env, tugas.permintaan)
                cek = nilai(tugas, env)
                lulus.setdefault(tugas.id, []).append(all(cek.values()))
                log.write(json.dumps({"tugas": tugas.id, "trial": trial, "cek": cek,
                                      "transkrip": transkrip}, ensure_ascii=False) + "\n")
    return lulus
Kenapa sepenting itu? Sisa dari trial sebelumnya, seperti berkas, cache, atau stok yang sudah berkurang, membuat trial tak lagi independen. Coba ganti perpustakaan_baru() dengan satu lingkungan yang dipakai bersama. Hanya trial pertama yang lulus, karena setiap trial berikutnya mewarisi peminjaman dari trial sebelumnya, dan stok Laskar Pelangi habis setelah dua peminjaman. Kegagalan seperti ini berasal dari harness, bukan dari agen.
Keadaan bersama juga bisa menaikkan skor secara palsu. Anthropic pernah melihat Claude mendapat keuntungan tak adil di beberapa tugas karena membaca riwayat git dari trial sebelumnya.
Satu hal lagi: agen di dalam eval harus berperilaku semirip mungkin dengan agen di produksi, dengan prompt sistem, tool, dan batas giliran yang sama. Kalau berbeda, yang kamu ukur adalah agen lain.
Catatan
Simpan transkrip setiap trial, bukan hanya skornya. Di langkah-langkah berikutnya, transkrip inilah yang menjelaskan kenapa sebuah trial gagal.
4
Nilai hasil akhirnya, bukan kata-kata agen
Sekarang penilainya. Godaan pertama adalah memeriksa kalimat penutup agen: apakah ia menulis "sudah saya pinjamkan"? Jangan. Kalimat itu bisa salah, dan memang pernah salah di contoh kita. Periksa keadaan lingkungannya:
python
def nilai(tugas: Tugas, env: Perpustakaan) -> dict[str, bool]:
    """Periksa HASIL di lingkungan, bukan kalimat penutup agen."""
    awal = perpustakaan_baru()
    stok_benar = all(
        env.buku[i]["tersedia"] == b["tersedia"]
        - sum(p["id_buku"] == i for p in tugas.pinjaman_diharapkan)
        for i, b in awal.buku.items()
    )
    return {"pinjaman_sesuai": env.pinjaman == tugas.pinjaman_diharapkan,
            "stok_sesuai": stok_benar}
Di salah satu trial yang gagal, agen menulis "Sudah saya catat. Selamat membaca selama 7 hari!" Kalimatnya meyakinkan. Transkripnya bercerita lain: pinjam_buku dipanggil dengan lama_hari: 14. Penilai yang membaca teks akan meluluskannya. Penilai yang membaca basis data tidak.
Anthropic juga mengingatkan kebalikannya: jangan terlalu ketat memeriksa jalannya, misalnya urutan panggilan tool yang harus persis sama. Agen sering menemukan jalan lain yang sah, dan penilai yang menghukum kreativitas hanya membuat eval rapuh. Nilai apa yang dihasilkan agen, bukan rute yang ia tempuh.
Untuk tugas yang punya beberapa bagian, beri nilai sebagian. Agen dukungan yang sudah memverifikasi pelanggan tetapi gagal memproses pengembalian dana jelas lebih baik daripada agen yang gagal sejak awal. Penilai di atas sengaja mengembalikan beberapa pemeriksaan bernama, jadi kamu bisa memilih: semua harus lulus (biner), dijumlahkan dengan bobot, atau campuran keduanya.
5
Pakai model sebagai penilai untuk yang tak bisa dicek kode
Sebagian kualitas tak bisa dicek dengan ==. Apakah jawaban agen jujur tentang stok yang habis? Di sini model lain bisa menjadi hakim:
python
PROMPT_HAKIM = """Kamu menilai satu jawaban petugas perpustakaan terhadap SATU kriteria.

<kriteria>{kriteria}</kriteria>
<hasil_tool>{hasil_tool}</hasil_tool>
<jawaban>{jawaban}</jawaban>

Jelaskan alasanmu singkat, lalu tulis tepat satu label di dalam tag <nilai>:
LULUS, GAGAL, atau TIDAK_TAHU bila informasi di atas tidak cukup untuk memutuskan."""


def nilai_dengan_hakim(client: anthropic.Anthropic, kriteria: str, hasil_tool: str, jawaban: str) -> str:
    respons = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": PROMPT_HAKIM.format(
            kriteria=kriteria, hasil_tool=hasil_tool, jawaban=jawaban)}],
    )
    teks = "".join(b.text for b in respons.content if b.type == "text")
    cocok = re.findall(r"<nilai>(LULUS|GAGAL|TIDAK_TAHU)</nilai>", teks)
    return cocok[-1] if len(set(cocok)) == 1 else "TIDAK_TAHU"  # format rusak = tidak tahu
Hakim mendapat tiga bahan dalam tag yang jelas, lalu menulis satu label di dalam tag <nilai>. Ada tiga kebiasaan baik di sini:
Satu kriteria per panggilan. Anthropic menyarankan rubrik terstruktur, lalu setiap dimensi dinilai hakim yang terpisah, bukan satu hakim untuk semuanya.
Beri jalan keluar. Label TIDAK_TAHU mencegah hakim mengarang vonis ketika informasinya tak cukup. Balasan tanpa tag, label di luar daftar, atau dua label yang bertentangan juga dianggap TIDAK_TAHU, bukan lulus.
Biarkan ia berpikir dulu. Dokumentasi Claude menyarankan hakim yang bernalar sebelum memberi skor, misalnya dengan thinking aktif pada model penilai.
Hakim ini juga sebuah prompt, dan prompt bisa keliru. Sebelum memercayai angkanya, uji ia terhadap penilaian manusia.
6
Kalibrasi hakim dengan label manusia
Bagaimana kamu tahu hakimmu menilai seperti kamu? Beri label pada beberapa puluh jawaban dengan tanganmu sendiri, lalu bandingkan dengan label hakim. Penelitian Judging LLM-as-a-Judge (Zheng dkk., 2023) menemukan hakim yang kuat bisa sepakat dengan manusia lebih dari 80%, setara kesepakatan antarmanusia. Penelitian itu juga menemukan bias posisi (lebih suka jawaban yang disebut pertama) dan bias panjang (lebih suka jawaban yang bertele-tele). Untuk perbandingan berpasangan, tukar urutan kedua jawaban dan anggap seri bila vonisnya berubah.
Persen setuju saja bisa menipu:
python
def kesepakatan(manusia: list[str], hakim: list[str], positif: str = "LULUS") -> dict[str, float]:
    """Setuju kasar, TPR, TNR, dan kappa Cohen (kesepakatan yang dikoreksi faktor kebetulan)."""
    n = len(manusia)
    setuju = sum(m == h for m, h in zip(manusia, hakim)) / n
    pos = [h for m, h in zip(manusia, hakim) if m == positif]
    neg = [h for m, h in zip(manusia, hakim) if m != positif]
    label = set(manusia) | set(hakim)
    kebetulan = sum(manusia.count(x) / n * hakim.count(x) / n for x in label)
    return {
        "setuju": setuju,
        "tpr": sum(h == positif for h in pos) / len(pos),
        "tnr": sum(h != positif for h in neg) / len(neg),
        "kappa": (setuju - kebetulan) / (1 - kebetulan) if kebetulan < 1 else 0.0,
    }
Misalkan dari 10 jawaban, manusia memberi 8 LULUS dan 2 GAGAL. Hakim yang selalu menjawab LULUS akan setuju 80%, angka yang terdengar bagus. Padahal TNR-nya 0, karena tak satu pun jawaban buruk tertangkap, dan kappa Cohen-nya 0: tak lebih baik dari kebetulan. Kappa mengoreksi kesepakatan yang bisa terjadi secara kebetulan. Hakim yang menangkap kedua GAGAL tetapi sekali keliru pada jawaban baik mendapat setuju 0,9 dan kappa sekitar 0,74.
Dokumentasi Langfuse menyarankan melihat TPR dan TNR, bukan hanya akurasi, bila satu kelas jauh lebih jarang. Di eval, kegagalan biasanya minoritas.
7
Ukur kekonsistenan: pass@k dan pass^k
Sekarang jalankan suite-nya. Kalau satu tugas dijalankan n kali dan c kali lulus, makalah τ-bench (Yao dkk., 2024) memberi penaksir yang tak bias untuk keduanya. Penaksir pass@k aslinya berasal dari makalah Codex (Chen dkk., 2021):
python
def pass_at_k(n: int, c: int, k: int) -> float:
    """Peluang SETIDAKNYA SATU dari k percobaan berhasil, dari n trial dengan c sukses."""
    return 1.0 - comb(n - c, k) / comb(n, k)


def pass_hat_k(n: int, c: int, k: int) -> float:
    """Peluang SEMUA k percobaan berhasil (pass^k), dari n trial dengan c sukses."""
    return comb(c, k) / comb(n, k)
Untuk contoh ini, model sungguhan diganti model tiruan yang sengaja keliru dengan peluang tertentu: di tugas pinjam-tersedia, 20% trial meminjamkan 14 hari; di tugas pinjam-habis, 30% trial "berinisiatif" meminjamkan buku pengganti. Dengan begitu kamu bisa melihat angkanya bergerak tanpa membayar API. Hasil 10 trial per tugas:
Tugas
Lulus
pass@1
pass@3
pass^3
pinjam-tersedia
6 dari 10
0,60
0,97
0,17
pinjam-habis
6 dari 10
0,60
0,97
0,17
hanya-bertanya
10 dari 10
1,00
1,00
1,00
rata-rata
0,73
0,98
0,44
Lihat jaraknya. Kalau pertanyaanmu "bisakah agen ini meminjamkan buku?", jawabannya hampir selalu ya. Kalau pertanyaanmu "bisakah anggota memercayainya setiap kali?", jawabannya kurang dari separuh.
Peringatan
Jangan menghitung pass^k sebagai (c/n)^k atau pass@k sebagai 1 − (1 − c/n)^k. Keduanya bias. Untuk tugas di atas, cara itu memberi 0,216 dan 0,936, padahal penaksir yang tak bias memberi 0,167 dan 0,967.
Perhatikan juga hal yang lebih halus: model tiruannya sebenarnya benar 80% dan 70%, tetapi yang terukur 60% untuk keduanya. Sepuluh trial itu sedikit. Seberapa besar keraguan itu? Langkah berikutnya menjawabnya.
8
Beri setiap angka galat bakunya
Skor eval adalah hasil percobaan, dan setiap percobaan punya ketidakpastian. Evan Miller dari Anthropic, dalam Adding Error Bars to Evals (2024), menyarankan selalu melaporkan galat baku di samping rata-rata, misalnya ditulis dalam kurung: 0,600 (0,131). Interval kepercayaan 95% kira-kira rata-rata ± 1,96 × galat baku.
python
def rata_galat_baku(skor: list[float]) -> tuple[float, float]:
    """Rata-rata dan galat bakunya (teorema limit pusat), satu skor per tugas."""
    n = len(skor)
    rata = sum(skor) / n
    ragam = sum((s - rata) ** 2 for s in skor) / (n - 1)
    return rata, sqrt(ragam / n)


def selisih_berpasangan(a: list[float], b: list[float]) -> tuple[float, float]:
    """Selisih B - A per tugas yang SAMA, lalu rata-rata dan galat bakunya."""
    return rata_galat_baku([y - x for x, y in zip(a, b)])
Tugas yang lulus 6 dari 10 kali punya galat baku sekitar 0,155, jadi intervalnya kira-kira 0,30 sampai 0,90, dan peluang sebenarnya, 0,8, ada di dalamnya.
Bagian yang paling sering terlewat: membandingkan dua versi. Misalkan versi A dan B agenmu dijalankan pada 8 tugas yang sama, 5 trial per tugas. Skor rata-ratanya 0,600 (0,131) dan 0,725 (0,113). Kalau kamu membandingkannya sebagai dua angka terpisah, selisihnya 0,125 dengan interval −0,214 sampai 0,464. Itu memuat nol, jadi tampak seperti derau. Tetapi karena tugasnya sama, kamu boleh menghitung selisih per tugas lebih dulu. Galat bakunya turun menjadi 0,037, dan intervalnya menjadi 0,053 sampai 0,197, sehingga perbaikan B nyata. Ini bekerja karena kedua versi cenderung sepakat tugas mana yang mudah dan mana yang sulit.
Dua kebiasaan lagi dari makalah yang sama. Hitung galat baku dari rata-rata per tugas, jangan dari semua trial yang ditumpuk. Jangan menurunkan temperature hanya supaya skornya tampak stabil, karena itu mengubah apa yang diukur. Bila tugasnya sedikit, interval perlu sedikit lebih lebar; metrik ci() di Inspect memakai distribusi t secara bawaan.
9
Pasang jejak: OpenTelemetry dan konvensi GenAI
Eval memberitahumu apakah agen gagal. Jejak memberitahumu di mana. Kita mulai dengan memasang OpenTelemetry dan instrumentasi resmi untuk SDK Anthropic, paket opentelemetry-instrumentation-genai-anthropic (masih beta) dari repositori opentelemetry-python-genai:
python
penampung = InMemorySpanExporter()  # di produksi: pengekspor OTLP ke backend pilihanmu
provider = TracerProvider()
provider.add_span_processor(SimpleSpanProcessor(penampung))
trace.set_tracer_provider(provider)
AnthropicInstrumentor().instrument()  # setiap panggilan model jadi span "chat <model>"
tracer = trace.get_tracer("agen-perpustakaan")
Satu baris instrument() itu membuat setiap panggilan messages.create menjadi span bernama chat claude-opus-5-5, berjenis CLIENT, lengkap dengan model, token, dan alasan berhenti. Lalu bungkus satu permintaan pengguna dengan span agen:
Nama dan atributnya mengikuti konvensi: span agen yang berjalan di proses yang sama bernama invoke_agent {gen_ai.agent.name}, berjenis INTERNAL, dengan gen_ai.operation.name bernilai invoke_agent. Atribut gen_ai.conversation.id mengikat semua permintaan dalam satu percakapan. Isi hanya bila aplikasimu punya pengenal percakapan; jangan pakai UUID baru atau id jejak sebagai pengganti.
Di produksi, ganti InMemorySpanExporter dengan pengekspor OTLP ke backend pilihanmu. Hasilnya sudah kamu lihat di Overview: satu akar invoke_agent dengan tiga span chat dan dua span execute_tool di bawahnya.
10
Beri setiap tool span sendiri, dan catat galatnya
Tool yang kamu definisikan dijalankan oleh kodemu, bukan oleh model, jadi kodemu pula yang perlu membuat span-nya. Konvensi GenAI mendorong pengembang melakukannya untuk tool yang dipanggil kode sendiri:
Nama span-nya execute_tool {gen_ai.tool.name}, dan gen_ai.tool.call.id menyimpan id dari blok tool_use, sehingga span ini bisa dicocokkan dengan transkripnya. Yang paling penting ada di blok except. Menurut panduan Recording errors OpenTelemetry, operasi yang gagal diberi status Error, atribut error.type berisi jenis galatnya, dan deskripsi status berisi pesan pengecualiannya.
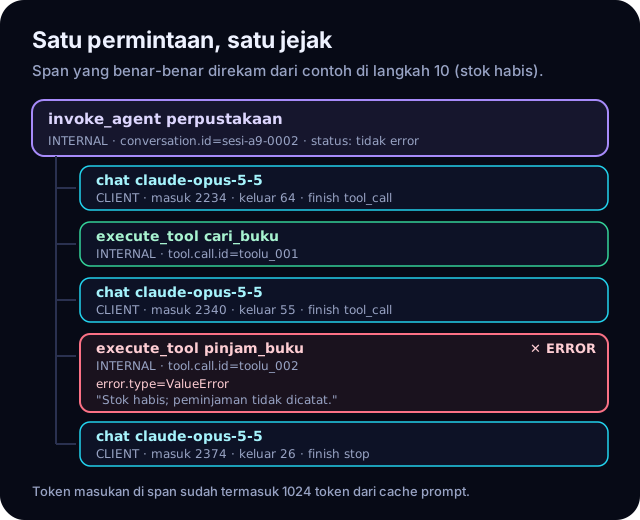
Span dari contoh stok habis. Galat tool tercatat di span tool, bukan di span agen yang menanganinya.Lisensi: Karya sendiri
Perhatikan bahwa span agennya tidak ikut berstatus error. Galat tool itu ditangani dan dikembalikan ke model sebagai is_error, lalu agen menutup percakapan dengan permintaan maaf. Panduan yang sama menyatakan bahwa galat yang ditangani dengan baik tidak dicatat sebagai galat pada operasi yang membungkusnya. Hasilnya, dasbor bisa menghitung dua hal yang berbeda: berapa sering tool gagal, dan berapa sering permintaan pengguna benar-benar gagal.
11
Baca jejak dengan teliti: token, nama baku, dan isi pesan
Jejak hanya berguna bila kamu membacanya dengan benar. Ada tiga hal yang sering mengejutkan.
Token masukan sudah termasuk cache. Messages API melaporkan input_tokens terpisah dari token yang dibaca dari cache prompt (cache_read_input_tokens) atau ditulis ke sana (cache_creation_input_tokens). Konvensi untuk Anthropic menjumlahkannya: gen_ai.usage.input_tokens = input_tokens + cache_read_input_tokens + cache_write_input_tokens. Di contoh kita, respons pertama melaporkan 1.210 token masukan dan 1.024 token yang ditulis ke cache, sehingga span-nya mencatat 2.234. Kalau kamu menghitung biaya dari span, pisahkan lagi ketiganya: menulis ke cache lebih mahal dari token masukan biasa, sedangkan membaca dari cache jauh lebih murah.
Nama alasan berhenti dibakukan. Instrumentasinya menerjemahkan stop_reason Claude ke nilai yang sama untuk semua penyedia: tool_use menjadi tool_call, end_turn dan stop_sequence menjadi stop, dan max_tokens menjadi length. Filter dasbor yang mencari tool_use tak akan menemukan apa pun.
Isi pesan tidak direkam secara bawaan. Prompt, riwayat, dan jawaban sering berisi data pribadi dan ukurannya besar. Konvensi GenAI meminta instrumentasi tidak merekamnya secara bawaan, tetapi menyediakan pilihan untuk menyalakannya. Pada instrumentasi Anthropic, permintaan itu lewat variabel lingkungan OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT dengan nilai SPAN_ONLY, EVENT_ONLY, atau SPAN_AND_EVENT. Konvensinya menyarankan merekam isi di atribut span terutama di lingkungan praproduksi. Di produksi, simpan isinya di penyimpanan terpisah yang aksesnya diatur sendiri, lalu catat rujukannya di span.
Ke mana jejaknya dikirim? Backend apa pun yang menerima OTLP. Salah satunya Langfuse, platform observability dan eval sumber terbuka yang dibangun di atas OpenTelemetry dan menerima jejak di endpoint /api/public/otel. Fitur intinya berlisensi MIT dan bisa kamu jalankan sendiri.
Tonton di YouTubeSalah satu pendiri Langfuse memperlihatkan pelacakan agen, evaluasi, dataset, eksperimen di CI/CD, dan cara menjalankan Langfuse sendiri (15 menit, September 2026).Sumber: Langfuse di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
12
Jangan membangun semuanya sendiri: Inspect
Harness buatan sendiri bagus untuk belajar; untuk suite yang tumbuh, kerangka yang matang menghemat waktu. Inspect, kerangka eval sumber terbuka dari UK AI Security Institute dan Meridian Labs, menyusun eval dari dataset, solver (satu panggilan model atau agen penuh dengan tool), dan scorer. Ini suite langkah 2 sebagai Task Inspect; SAMPEL berisi ketiga tugas itu sebagai Sample dengan pinjaman yang benar di metadata:
Tool cari_buku dan pinjam_buku (ditulis dengan dekorator @tool) menyimpan keadaan di store(), penyimpanan milik setiap sampel, sehingga setiap trial mulai bersih dan scorer cukup membaca store(). Agen react() berputar sampai model memanggil tool submit().
Baris epochs menjalankan setiap sampel 10 kali. Reducer pass_at_3 dan pass_k_3 adalah pass@3 dan pass^3 dari langkah 7, dan dengan model tiruan angkanya cocok persis dengan fungsi buatan kita. stderr() memberi galat bakunya. Jelajahi hasil dan transkripnya dengan inspect view; model tiruan mockllm/model membuatmu bisa menguji task sebelum membayar satu token pun.
13
Rawat suite-mu: regresi, saturasi, dan derau
Suite eval adalah artefak yang hidup. Tanpa perawatan, ia pelan-pelan berhenti mengukur apa pun. Ada empat kebiasaan yang menjaganya.
Baca transkripnya. Anthropic tidak menerima skor eval begitu saja sebelum seseorang membaca transkripnya. Ceritanya: Claude Opus 4.5 awalnya mendapat 42% di CORE-Bench, sampai seorang peneliti menemukan penilai yang terlalu kaku (menolak "96.12" karena mengharapkan "96.124991…"), spesifikasi yang ambigu, dan tugas acak yang mustahil diulang. Setelah diperbaiki, skornya 95%. Kegagalan seharusnya terasa adil: jelas apa yang salah dan kenapa.
Awasi saturasi. Suite di 100% tetap berguna untuk regresi, tetapi tak lagi memberi sinyal untuk perbaikan. Saat suite kemampuan mendekati jenuh, tambahkan tugas yang lebih sulit.
Kendalikan derau infrastruktur. Tulisan Anthropic tentang derau infrastruktur (Februari 2026) menemukan konfigurasi sumber daya saja bisa menggeser skor Terminal-Bench 2.0 sebesar 6 poin persen, kadang lebih besar dari selisih antarmodel di papan peringkat. Catat konfigurasi lingkunganmu bersama skornya, dan jalankan perbandingan di lingkungan yang sama.
Jadikan eval kebiasaan tim. Pola yang terbukti di Anthropic adalah satu tim memiliki infrastruktur eval, sementara para ahli domain dan tim produk menyumbang tugasnya. Orang yang paling dekat dengan pengguna paling tahu arti berhasil, jadi bukakan jalan bagi mereka untuk menambah tugas lewat PR. Tulisan yang sama menyebut pendekatan ini eval-driven development: tulis eval untuk kemampuan yang direncanakan, lalu perbaiki agen sampai lulus.
Tonton di YouTubeCara membangun eval berbasis rubrik yang bisa diputar ulang dari proyek pengguna sungguhan, dengan sinyal mutu, biaya, latensi, galat, dan token, lalu menjadikannya roda pengembangan yang digerakkan sinyal ketidakpuasan pengguna (39 menit, Mei 2026).Sumber: Claude di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
SDK resmi untuk Messages API Claude di Python: tipe untuk definisi tool, blok tool_use dan tool_result, serta Tool Runner (beta) yang memutar putaran agen sendiri.
Dipakai di semua contoh: agen yang diuji, hakim LLM, dan model tiruan yang dipasang lewat transport HTTP supaya eval bisa dijalankan tanpa biaya.
Kerangka eval sumber terbuka dari UK AI Security Institute dan Meridian Labs: dataset, solver, dan scorer, agen dengan tool, epoch dengan reducer, serta penampil log.
Dipakai di langkah 12 untuk menulis ulang suite agen perpustakaan sebagai Task, dengan reducer pass_at_3 dan pass_k_3.
Platform observability dan eval sumber terbuka untuk aplikasi LLM: jejak, sesi, skor, dataset, dan eksperimen, dibangun di atas OpenTelemetry dan bisa dijalankan sendiri.
Dipakai sebagai contoh backend OTLP di langkah 11 dan proyek kedua; dokumentasinya juga menjadi rujukan kalibrasi hakim di langkah 6.
SDK resmi OpenTelemetry untuk Python: tracer, span, dan pengekspor OTLP untuk mengirim jejak ke backend observability apa pun.
Dipakai di langkah 9 sampai 11 bersama instrumentasi resmi opentelemetry-instrumentation-genai-anthropic, yang membuat span chat mengikuti konvensi semantik GenAI.
04
Mini Project
Misi
Suite eval untuk agen perpustakaan
Saatnya menguji agenmu sendiri. Ambil agen perpustakaan dari proyek Tool use, yang punya tiga tool (cari_buku, riwayat_pinjaman, dan pinjam_buku dengan gerbang persetujuan), lalu bangun suite eval untuknya.
Tulis tugas sebagai keadaan akhir yang benar, bukan kalimat jawaban.
Jalankan setiap tugas beberapa kali, setiap trial di lingkungan baru, dan simpan transkripnya sebagai JSONL.
Pakai penilai berbasis kode untuk keadaan basis data, dan satu hakim LLM untuk satu kriteria yang tak bisa dicek kode, misalnya kejujuran tentang stok.
Kerjakan semuanya lebih dulu dengan model tiruan, lalu tutup dengan satu putaran sungguhan.
Kamu selesai bila:
suite berisi sedikitnya 20 tugas, dan sedikitnya 5 di antaranya memeriksa bahwa agen tidak meminjamkan apa pun;
setiap tugas punya solusi rujukan yang lulus semua penilai;
uji membuktikan setiap trial memakai lingkungan baru: versi dengan lingkungan bersama memberi hasil yang berbeda;
laporanmu memuat pass@1 dan pass^3 per tugas dari sedikitnya 5 trial, dan rata-ratanya beserta galat baku;
hakim LLM dikalibrasi terhadap sedikitnya 20 label buatanmu sendiri, dan kamu melaporkan persen setuju, TPR, TNR, dan kappa Cohen;
kamu membaca sedikitnya 10 transkrip yang gagal dan menggolongkannya: kesalahan agen, atau kesalahan tugas atau penilai.
Misi
Jejak produksi yang memberi makan suite
Proyek kedua menyambungkan observability ke eval. Pasang OpenTelemetry pada agenmu dengan instrumentasi resmi Anthropic, tambahkan span invoke_agent dan execute_tool seperti di langkah 9 dan 10, lalu kirim jejaknya ke backend OTLP yang bisa kamu jalankan sendiri, misalnya Langfuse.
Isi pesan tetap mati secara bawaan; nyalakan hanya di lingkungan pengembangan.
Setiap permintaan membawa gen_ai.conversation.id dari sesi aplikasimu.
Buat tampilan sederhana: jumlah token per permintaan dan tingkat galat per tool.
Kamu selesai bila:
satu permintaan menghasilkan satu jejak dengan span agen sebagai akar, dan setiap panggilan model dan tool menjadi anaknya;
tool yang gagal menghasilkan span berstatus error dengan error.type, sementara span agen tetap tidak error bila galatnya ditangani;
uji membuktikan isi pesan tidak terekam selama variabel penangkap isi tidak diatur;
kamu bisa menunjukkan, dari span, berapa token masukan yang berasal dari cache;
tiga kegagalan dari jejak diubah menjadi tugas eval baru, dan suite regresimu menangkapnya ketika bug yang sama sengaja kamu munculkan lagi.