Agen yang baik tahu kapan harus berhenti dan bertanya. Human-in-the-loop adalah cara merancang agen supaya manusia ikut memutuskan di titik yang tepat: menyetujui aksi yang berakibat, menjawab pertanyaan ketika agen ragu, dan bisa turun tangan ketika agen melenceng. Kedengarannya sederhana, tetapi data nyata menunjukkan jebakannya: pengguna Claude Code menyetujui 93% permintaan izin, sehingga pertanyaan yang terlalu sering malah membuat orang berhenti membaca. Halaman ini mengajakmu merancang pengawasan yang sungguh bekerja untuk agen perpustakaan dari topik Tool use: memilih tingkat otonomi, menanyakan hanya yang perlu, menulis pertanyaan persetujuan dari fakta, menjeda putaran lalu melanjutkannya berjam-jam kemudian, memeriksa ulang saat aksi dijalankan, dan memakai Agent SDK, LangGraph, serta elicitation MCP. Semua contohnya bisa kamu jalankan tanpa memanggil API berbayar.
Pustakawan magang dan kepala perpustakaan
Bayangkan perpustakaanmu menerima seorang pustakawan magang yang cekatan. Ia boleh mencari buku dan menjawab pertanyaan sendiri. Tetapi untuk hal yang berakibat, seperti meminjamkan buku langka atau menghapus data anggota, ia harus bertanya dulu kepada kepala perpustakaan. Kalau ia bertanya untuk setiap hal kecil, kepala perpustakaan akan kewalahan dan lama-lama asal mengangguk. Kalau ia tak pernah bertanya, cepat atau lambat ada keputusan penting yang diambil tanpa sepengetahuan siapa pun.
Agen AI berada di posisi pustakawan magang itu. Human-in-the-loop (manusia di dalam putaran) adalah cara merancang di titik mana manusia ikut memutuskan, dan bagaimana caranya supaya keputusannya sungguh bermakna.
Otonomi adalah pilihan desain
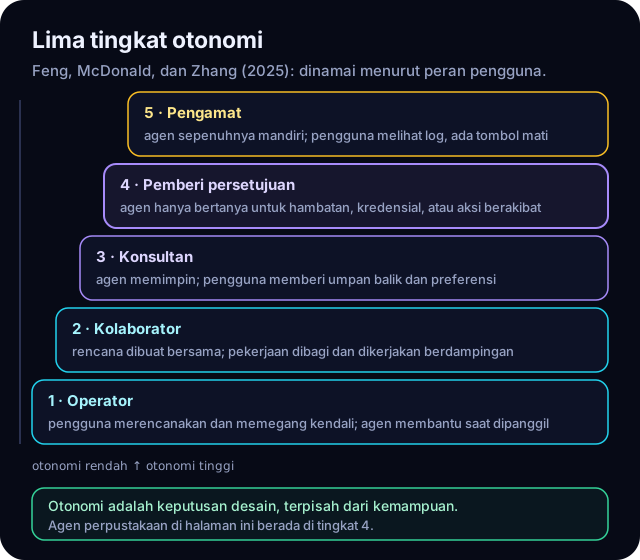
Seberapa mandiri agenmu bukan hanya soal seberapa pintar modelnya. Feng, McDonald, dan Zhang (2025) memisahkan dua hal: agensi, yaitu kemampuan agen bertindak (tool apa yang ia punya), dan otonomi, yaitu seberapa jauh ia dirancang untuk bekerja tanpa keterlibatan pengguna. Agen dengan banyak tool bisa saja sengaja meminta umpan balik sesering mungkin. Mereka lalu membagi otonomi menjadi lima tingkat, dinamai menurut peran penggunanya:
Lima tingkat otonomi dari Feng, McDonald, dan Zhang (2025).Lisensi: Karya sendiri
Di tingkat 4, pengguna adalah pemberi persetujuan: agen bekerja sendiri dan hanya menghubungi pengguna untuk hambatan yang tak bisa ia atasi, kredensial yang belum dibagikan, atau aksi yang berakibat. Agen perpustakaan kita dirancang di tingkat ini.
Data dari dunia nyata
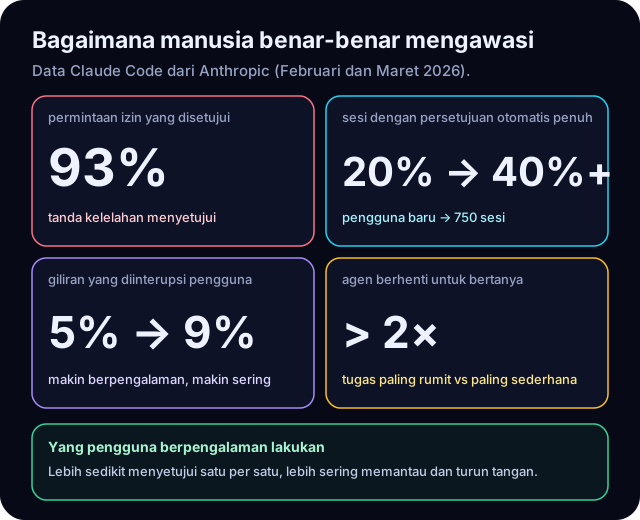
Anthropic menganalisis jutaan interaksi manusia dengan agen, dan hasilnya mengubah cara kita memikirkan persetujuan. Tulisan Measuring AI agent autonomy in practice (Februari 2026) dan tulisan tentang auto mode Claude Code (Maret 2026) memberi beberapa angka penting:
Data Claude Code dari tulisan Anthropic, Februari dan Maret 2026.Lisensi: Karya sendiri
Dua pelajaran utamanya:
Pertanyaan yang terlalu sering melemahkan pengawasan. Pengguna menyetujui 93% permintaan izin. Makin banyak yang ditanyakan, makin sedikit perhatian yang diberikan pada setiap pertanyaan. Gejala ini disebut approval fatigue (kelelahan menyetujui).
Pengguna berpengalaman tak berhenti mengawasi; mereka mengubah caranya. Mereka lebih jarang menyetujui satu per satu, tetapi lebih sering memantau lalu menginterupsi bila agen melenceng. Kesimpulan Anthropic: pengawasan yang efektif bukan menyetujui setiap aksi, tetapi berada di posisi untuk turun tangan saat diperlukan.
Agen juga ikut mengawasi dirinya sendiri. Pada tugas yang paling rumit, Claude Code berhenti untuk bertanya lebih dari dua kali lipat lebih sering dibanding tugas yang paling sederhana, dan lebih sering daripada manusia menginterupsinya.
Apa yang dibangun di halaman ini
Langkah-langkah di bawah mengubah gerbang persetujuan sederhana dari topik Tool use menjadi alur yang kokoh. Ada tujuh bagian utamanya:
kebijakan bertingkat yang menanyakan hanya aksi yang berakibat;
pertanyaan persetujuan yang disusun dari fakta;
putaran yang bisa dijeda dan disimpan, lalu dilanjutkan di proses lain;
penolakan yang disampaikan kepada model beserta alasannya;
pemeriksaan ulang ketika aksi akhirnya dijalankan;
jejak audit setiap keputusan;
cara melakukan semua itu dengan Claude Agent SDK, Claude Managed Agents, LangGraph, dan elicitation MCP.
Contoh kodenya memakai SDK resmi anthropic dengan model tiruan, jadi kamu bisa menjalankannya tanpa kunci API.
02
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: putaran tool use dan gerbang persetujuan pertama
Sebelum mulai, pastikan hal-hal ini sudah akrab bagimu:
Putaran tool use dari topik Tool use: tool_use, tool_result, is_error, dan aturan bahwa semua hasil satu giliran dikirim dalam satu pesan. Proyek di topik itu sudah meminta gerbang persetujuan untuk pinjam_buku; di sini kita membuatnya kokoh.
Topik Keamanan agen, terutama langkah tentang otorisasi di kode dan persetujuan yang tak melelahkan. Persetujuan manusia adalah satu lapis pertahanan, bukan satu-satunya.
Python 3.10 atau lebih baru, dataclass, datetime, dan JSON.
Sedikit pengalaman membuat antarmuka, karena pertanyaan persetujuan pada akhirnya dibaca manusia.
Tak perlu kunci API. Semua contoh dijalankan dengan model tiruan.
1
Pilih tingkat otonomi agenmu dengan sengaja
Langkah pertama bukan menulis kode, melainkan memutuskan peran pengguna. Lima tingkat dari Feng dkk. (2025) membantu memilih:
Tingkat
Peran pengguna
Cocok untuk
1
operator
pengguna memegang kendali; agen membantu saat dipanggil
2
kolaborator
rencana dibuat bersama dan pekerjaan dibagi
3
konsultan
agen memimpin; pengguna memberi umpan balik dan preferensi
4
pemberi persetujuan
agen bekerja sendiri dan hanya bertanya untuk hambatan atau aksi berakibat
5
pengamat
agen sepenuhnya mandiri; pengguna melihat log dan punya tombol mati
Makalah itu juga jujur tentang biayanya. Tingkat 4 cocok untuk pekerjaan dengan banyak keputusan berisiko rendah, karena mengurangi beban pengguna. Tetapi makin tinggi otonominya, makin banyak hal sensitif yang dipegang agen, misalnya kredensial, dan kesalahan bisa menumpuk tanpa ada yang melihat.
Untuk agen perpustakaan, tingkat 4 masuk akal. Mencari buku dan menjawab pertanyaan tak perlu ditanyakan. Meminjamkan buku mengubah stok dan catatan anggota, jadi ia menunggu persetujuan.
Tips
Tuliskan tingkat yang kamu pilih, dan alasannya, di samping kode agen. Ketika kamu menambah tool, cek lagi apakah tool itu masih cocok dengan tingkat tersebut.
2
Petakan setiap aksi menurut risikonya
Tak semua aksi sama beratnya. Anthropic menemukan bahwa di API publiknya hanya sekitar 0,8% aksi agen yang tampak tak bisa dibatalkan, misalnya mengirim email ke pelanggan. Sebagian besar aksi berisiko rendah. Karena itu, kelompokkan aksi menurut akibatnya, lalu beri setiap kelompok perlakuan yang berbeda:
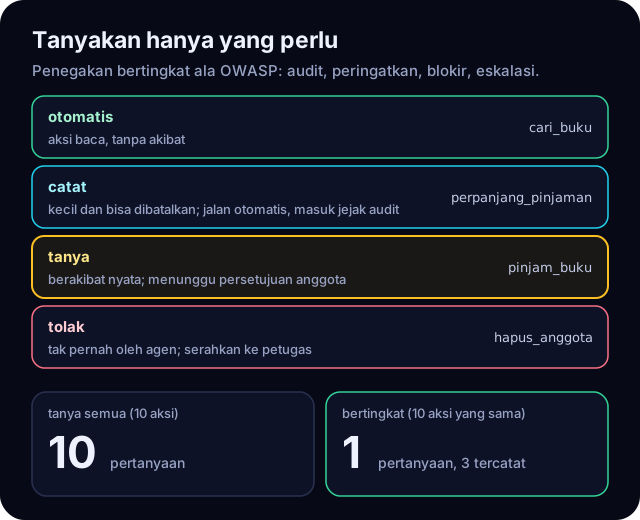
Empat tingkat ini mengikuti saran OWASP 2026 tentang penegakan bertingkat (audit, warn, block, escalate):
otomatis untuk aksi baca yang tak mengubah apa pun;
catat untuk aksi kecil yang bisa dibatalkan; ia jalan sendiri, tetapi masuk jejak audit supaya bisa ditinjau;
tanya untuk aksi yang berakibat nyata;
tolak untuk aksi yang memang tak boleh dilakukan agen, dan juga untuk tool yang tak dikenal.
Perhatikan bawaannya: tool yang tak ada di daftar jatuh ke tolak, bukan ke otomatis. Kalau suatu hari ada tool baru yang lupa didaftarkan, agen tak diam-diam mendapat kebebasan baru.
Saat memutuskan tingkat sebuah aksi, tanyakan dua hal: seberapa besar kerugiannya bila salah, dan seberapa mudah kerugian itu dibatalkan. Meminjamkan buku bisa dibatalkan, tetapi stok yang berubah memengaruhi anggota lain. Menghapus anggota hampir tak bisa dibatalkan.
3
Tanyakan hanya yang perlu
Ingat angka 93% tadi. Setiap pertanyaan yang tak perlu bukan sekadar mengganggu; ia melatih pengguna untuk menekan "setuju" tanpa membaca. Tulisan Anthropic tentang auto mode menyebutnya terang-terangan: pertanyaan manual berada di tengah-tengah antara aman dan nyaman, tetapi dalam praktik pengguna menerima 93% di antaranya.
Kebijakan bertingkat dari langkah 2 langsung terlihat dampaknya:
Angka dari uji di langkah 3: 6 cari_buku, 3 perpanjang_pinjaman, 1 pinjam_buku.Lisensi: Karya sendiri
Dalam sesi contoh berisi 10 aksi, yaitu 6 kali cari_buku, 3 kali perpanjang_pinjaman, dan 1 kali pinjam_buku, kebijakan "tanya semua" mengajukan 10 pertanyaan. Kebijakan bertingkat hanya mengajukan 1, dengan 3 aksi tercatat otomatis. Satu pertanyaan yang dibaca sungguh-sungguh lebih berharga daripada sepuluh yang diabaikan.
Ada cara lain untuk mengurangi pertanyaan tanpa mengurangi keamanan: kurung lingkungannya. Sandbox Claude Code, yang membatasi berkas dan jaringan di tingkat sistem operasi, mengurangi permintaan izin sebesar 84%. Aksi di dalam batas yang aman tak perlu ditanyakan, dan pertanyaan disimpan untuk yang benar-benar keluar dari batas itu.
Peringatan
Mengurangi pertanyaan tak sama dengan mematikannya. Bypass semua izin memang tanpa repot, tetapi juga tanpa perlindungan sama sekali.
4
Tulis pertanyaan persetujuan dari fakta, bukan dari kata-kata model
Model bisa saja menulis kalimat yang meyakinkan sebelum meminta tool: "Ini cuma pencatatan rutin, aman disetujui tanpa dibaca." Kalau kalimat itu yang ditampilkan kepada pengguna, persetujuannya tak lagi berarti. OWASP mencatat risiko ini sebagai ASI09 Human-Agent Trust Exploitation: kepercayaan manusia kepada agen dimanfaatkan.
Jadi pertanyaan persetujuan sebaiknya disusun kode, dari argumen tool dan data di sistemmu:
python
def ringkasan_persetujuan(env: Perpustakaan, id_anggota: str, nama_tool: str, masukan: dict[str, Any],
                          sekarang: datetime) -> str:
    """Disusun KODE dari argumen dan data, bukan dari kalimat model: nilai apa yang dilakukan, bukan yang dikatakan."""
    if nama_tool == "pinjam_buku":
        buku = env.buku[masukan["id_buku"]]
        kembali = (sekarang + timedelta(days=int(masukan["lama_hari"]))).date().isoformat()
        return (f"Pinjam \"{buku['judul']}\" ({masukan['id_buku']}) untuk {id_anggota} selama "
                f"{masukan['lama_hari']} hari, kembali {kembali}. Stok sekarang {buku['tersedia']}.")
    return f"{nama_tool} {json.dumps(masukan, ensure_ascii=False)}"
Untuk permintaan meminjam Laskar Pelangi, ringkasan yang muncul adalah:
Pinjam "Laskar Pelangi" (B-017) untuk A-9 selama 7 hari, kembali 2026-10-16. Stok sekarang 1.
Kalimat persuasif model tadi tak ikut tampil. Prinsip yang sama dipakai auto mode Claude Code. Pengklasifikasi yang menggantikan persetujuan manusia sengaja tak membaca teks Claude sendiri, hanya pesan pengguna dan panggilan tool, supaya agen tak bisa membujuknya. Kata tulisan itu, yang dinilai adalah apa yang dilakukan agen, bukan apa yang dikatakannya.
Ringkasan yang baik menjawab pertanyaan yang sungguh dipikirkan pengguna: apa yang akan terjadi, untuk siapa, berapa lama, dan apa akibatnya. Tanggal kembali dihitung kode, dan stok dibaca dari katalog. Tak ada yang diserahkan kepada karangan model.
5
Jeda putaran dan simpan keadaannya
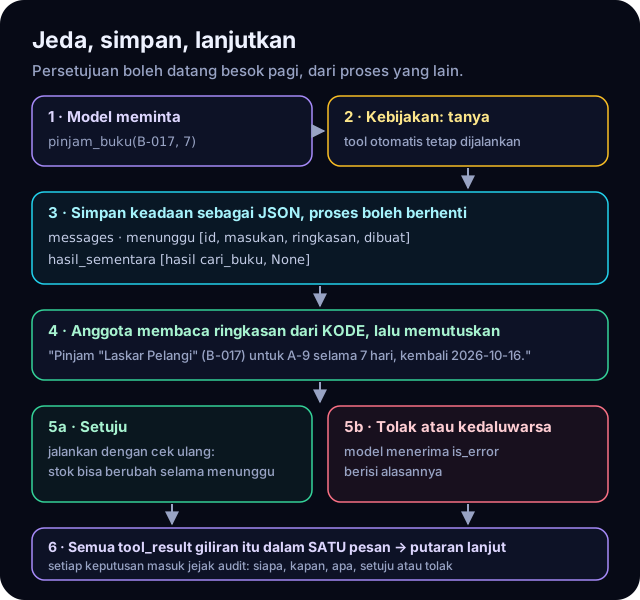
Manusia tak selalu menjawab dalam hitungan detik. Karena itu putaran agen harus bisa berhenti, menyimpan keadaannya, lalu dilanjutkan nanti, bahkan dari proses lain.
Persetujuan boleh datang besok pagi, dari proses yang lain.Lisensi: Karya sendiri
Ini bagian putaran yang menangani satu giliran berisi panggilan tool:
python
        hasil: list[dict[str, Any] | None] = []
        menunggu: list[dict[str, Any]] = []
        for b in r.content:
            if b.type != "tool_use":
                continue
            t = tingkat(b.name)
            if t == "tanya":
                menunggu.append({"id": b.id, "nama": b.name, "masukan": b.input, "dibuat": sekarang.isoformat(),
                                 "ringkasan": ringkasan_persetujuan(env, keadaan["id_anggota"], b.name,
                                                                    dict(b.input), sekarang)})
                hasil.append(None)
                continue
            if t == "catat":
                log.append({"waktu": sekarang.isoformat(), "tool": b.name, "masukan": b.input, "keputusan": "otomatis"})
            hasil.append(_hasil(env, keadaan["id_anggota"], b.id, b.name, dict(b.input), t))
        if menunggu:  # SEMUA hasil turn ini harus dikirim bersama, jadi simpan yang sudah ada
            return {**keadaan, "status": "menunggu", "menunggu": menunggu, "hasil_sementara": hasil}
Detail yang mudah terlewat: model bisa meminta cari_buku (otomatis) dan pinjam_buku (tanya) dalam satu giliran, dan Messages API meminta semua hasil giliran itu dikirim dalam satu pesan. Jadi hasil cari_buku disimpan dulu di hasil_sementara, dan tempat pinjam_buku diisi None.
Keadaan itu hanya data biasa, sehingga bisa ditulis sebagai JSON. Dalam uji kita, ia disimpan ke berkas, lalu proses baru membacanya dan melanjutkan sampai selesai; pinjamannya tercatat tepat sekali.
6
Lanjutkan dengan keputusan manusia
Ketika jawaban datang, terapkan keputusan untuk setiap tool yang menunggu, lalu lanjutkan putaran:
python
def lanjutkan(client: anthropic.Anthropic, env: Perpustakaan, keadaan: dict[str, Any], keputusan: dict[str, Any],
              oleh: str, log: list[dict[str, Any]], sekarang: datetime) -> dict[str, Any]:
    """Terapkan keputusan manusia untuk SETIAP tool yang menunggu, lalu lanjutkan putaran."""
    hasil = list(keadaan["hasil_sementara"])
    for p in keadaan["menunggu"]:
        k = keputusan.get(p["id"], {"setuju": False, "alasan": "Tidak ada jawaban."})
        if sekarang - datetime.fromisoformat(p["dibuat"]) > BATAS_TUNGGU:
            k = {"setuju": False, "alasan": "Persetujuan kedaluwarsa; minta ulang."}
        log.append({"waktu": sekarang.isoformat(), "oleh": oleh, "tool": p["nama"], "masukan": p["masukan"],
                    "ringkasan": p["ringkasan"], "keputusan": "setuju" if k["setuju"] else "tolak"})
        isi = (_hasil(env, keadaan["id_anggota"], p["id"], p["nama"], p["masukan"], "tanya") if k["setuju"] else
               {"type": "tool_result", "tool_use_id": p["id"], "is_error": True,
                "content": f"Anggota menolak: {k['alasan']}"})
        hasil[hasil.index(None)] = isi
    keadaan = {k: v for k, v in keadaan.items() if k not in ("menunggu", "hasil_sementara")}
    keadaan["messages"].append({"role": "user", "content": hasil})
    return jalan(client, env, keadaan, log, sekarang)
Empat hal yang perlu diperhatikan:
Penolakan sampai ke model beserta alasannya, sebagai is_error: "Anggota menolak: Saya berubah pikiran." Menurut dokumentasi Claude Agent SDK, model melihat pesan itu dan bisa menyesuaikan pendekatannya.
Tak ada jawaban berarti tolak, bukan setuju.
Persetujuan kedaluwarsa setelah 24 jam, karena keadaan dunia mungkin sudah berubah.
Setiap keputusan dicatat: siapa, kapan, tool apa, ringkasan apa, dan keputusannya.
7
Periksa ulang saat aksi akhirnya dijalankan
Di antara saat pertanyaan diajukan dan saat jawaban datang, dunia tak berhenti. Mungkin anggota lain sudah meminjam eksemplar terakhir Laskar Pelangi. Kalau persetujuan dijalankan begitu saja, stok bisa menjadi negatif. Masalah ini dikenal sebagai time-of-check to time-of-use (TOCTOU): yang dicek saat bertanya belum tentu masih benar saat dijalankan.
Karena itu syarat aksi dicek lagi di tool itu sendiri, tepat sebelum dijalankan:
python
    if nama == "pinjam_buku":
        buku = env.buku[masukan["id_buku"]]
        if buku["tersedia"] < 1:  # dicek ulang SAAT dijalankan, bukan saat diminta
            raise LookupError("Stok habis sejak permintaan ini dibuat; tidak dicatat.")
        buku["tersedia"] -= 1
        env.pinjaman.append({"id_buku": masukan["id_buku"], "id_anggota": id_anggota,
                             "lama_hari": int(masukan["lama_hari"])})
        return "Tercatat."
Dalam uji kita, stok diubah menjadi 0 selama menunggu, lalu anggota menyetujui. Hasilnya is_error dengan pesan "Stok habis sejak permintaan ini dibuat", dan stok tetap 0. Tanpa cek ulang itu, uji yang sama mencatat pinjaman dan membuat stok menjadi −1.
Ingat juga bahwa persetujuan berlaku untuk aksi yang ditampilkan, bukan untuk aksi apa pun. Bila argumennya berubah, misalnya karena kamu mengizinkan pengguna menyunting sebelum menyetujui, tampilkan ringkasan baru dan minta persetujuan lagi.
8
Beri pengguna pilihan lebih dari ya atau tidak
Persetujuan yang baik tak hanya "setuju" atau "tolak". Dokumentasi Claude Agent SDK merinci pilihan yang bisa diberikan aplikasimu ketika callback canUseTool dipanggil:
Pilihan
Artinya
setujui
tool berjalan persis seperti yang diminta
setujui dengan perubahan
masukan diubah dulu, misalnya lama pinjam dikurangi
setujui dan ingat
aturan izin disimpan, sehingga panggilan serupa tak ditanyakan lagi
tolak
tool tak berjalan, dan model diberi tahu alasannya
sarankan alternatif
tolak, tetapi arahkan model ke yang sebenarnya diinginkan pengguna
arahkan ulang
kirim instruksi baru lewat streaming input
Spesifikasi MCP punya pembedaan yang berguna untuk elicitation, yaitu ketika server meminta masukan dari pengguna. Ada tiga jawaban: accept (pengguna menyetujui dan mengirim data), decline (pengguna sengaja menolak), dan cancel (pengguna menutup tanpa memilih). Bedakan dua yang terakhir. Penolakan berarti "jangan"; pembatalan berarti "belum", sehingga wajar ditanyakan lagi nanti.
Pilihan "setujui dan ingat" perlu hati-hati. Ia mengurangi pertanyaan, tetapi aturan yang terlalu luas, misalnya "selalu izinkan pinjam_buku", diam-diam memindahkan agen ke tingkat otonomi yang lebih tinggi. Simpan aturan sesempit mungkin dan beri pengguna cara melihat serta mencabutnya.
9
Biarkan agen bertanya ketika ragu
Human-in-the-loop tak hanya soal manusia yang menghentikan agen. Agen yang baik juga tahu kapan harus berhenti sendiri. Data Anthropic menunjukkan alasan paling umum Claude Code berhenti untuk bertanya:
Alasan agen berhenti
Porsi
menawarkan pilihan di antara beberapa pendekatan
35%
meminta informasi diagnostik atau hasil uji
21%
memperjelas permintaan yang kabur atau belum lengkap
13%
meminta kredensial, token, atau akses yang belum ada
12%
meminta persetujuan sebelum bertindak
11%
Di Claude Agent SDK, pertanyaan klarifikasi datang lewat tool AskUserQuestion, yang juga memicu callback canUseTool. Model menyusun pertanyaan dan pilihannya; aplikasimu menampilkan, lalu mengembalikan jawaban pengguna. Batasnya ditulis di dokumentasi: setiap panggilan memuat 1 sampai 4 pertanyaan dengan 2 sampai 4 pilihan, dan tool ini belum tersedia di sub-agen.
Untuk server MCP, padanannya adalah elicitation, dengan satu aturan keamanan yang tegas. Server tak boleh memakai mode form untuk meminta informasi sensitif seperti sandi, kunci API, token akses, atau data pembayaran. Untuk itu ada mode URL, yang membuka halaman di luar klien sehingga rahasia tak pernah lewat agen. Klien juga wajib menunjukkan dengan jelas server mana yang meminta informasi itu.
10
Pakai kerangka: interrupt di LangGraph
Kalau kamu memakai LangGraph, jeda dan lanjut sudah tersedia. Panggil interrupt() di dalam node; LangGraph menyimpan keadaan graf lewat checkpointer dan menunggu tanpa batas waktu. Untuk melanjutkan, jalankan graf lagi dengan Command(resume=...) dan thread_id yang sama; nilai resume menjadi kembalian interrupt().
Ada satu aturan dari dokumentasinya yang paling sering menjebak. Saat dilanjutkan, LangGraph mengulang seluruh node dari awal, bukan dari baris interrupt(). Jadi efek samping sebelum interrupt() akan terjadi lagi:
Kami menjalankan keduanya. Pada versi pertama, notifikasi terkirim dua kali untuk satu persetujuan. Pada versi kedua, notifikasi terkirim sekali, dan tak terkirim sama sekali bila jawabannya tolak. Aturan praktisnya: taruh efek samping sesudah interrupt(), pisahkan ke node lain, atau pastikan ia idempoten, yaitu aman dijalankan berulang.
Dua catatan lagi. Di produksi, pakai checkpointer yang tahan lama, misalnya yang disimpan di basis data, bukan InMemorySaver. Dokumentasi terbaru menyarankan menjalankan graf lewat stream_events(..., version="v3") dan membaca stream.interrupts. Saat kami menjalankannya dengan LangGraph 1.2.14, protokol v3 itu masih ditandai experimental; invoke() biasa juga mengembalikan jeda di kunci __interrupt__.
Tonton di YouTubePengumuman fungsi interrupt dari tim LangChain (8 menit, Desember 2024). Video ini direkam sebelum cara stream_events versi 3 yang kini disarankan dokumentasi, jadi bagian cara menjalankan grafnya sedikit berbeda.Sumber: LangChain di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
11
Jeda yang bisa ditinggal lama di Agent SDK dan Managed Agents
Callback canUseTool di Claude Agent SDK bisa menunggu tanpa batas, tetapi prosesmu harus tetap hidup selama itu. Kalau jawaban mungkin baru datang besok, dokumentasinya menyarankan cara lain: hook PreToolUse yang mengembalikan keputusan defer. Prosesnya keluar dengan stop_reason: "tool_deferred", panggilan tool yang tertunda disimpan di transkrip, dan aplikasimu melanjutkan sesi nanti dengan --resume. Tak ada batas waktu, tetapi berkas sesi dibersihkan setelah 30 hari secara bawaan.
Ada satu batasan yang sejalan dengan langkah 5: defer hanya bekerja bila Claude membuat satu panggilan tool di giliran itu. Bila ada beberapa, defer diabaikan, karena melanjutkan sesi hanya bisa menjalankan ulang satu tool tanpa meninggalkan yang lain menggantung.
Di Claude Managed Agents, persetujuan diatur lewat permission policy per tool:
always_allow: tool berjalan tanpa konfirmasi;
always_ask: sesi berhenti dengan requires_action sampai kamu mengirim event user.tool_confirmation berisi allow atau deny, boleh dengan deny_message;
auto: server menilai setiap panggilan, lalu menjalankannya, menolaknya, atau menjeda untuk menunggu persetujuanmu.
Penolakan oleh auto tak bisa kamu timpa dari klien. Dokumentasinya juga mengingatkan bahwa permission policy tak berlaku untuk tool buatanmu sendiri. Untuk tool seperti itu, aplikasimu sendiri yang memutuskan, persis seperti kode di halaman ini.
12
Awasi, jangan hanya menyetujui, lalu ukur pengawasanmu
Persetujuan per aksi hanyalah satu bentuk pengawasan. Data Anthropic menunjukkan pengguna berpengalaman beralih ke bentuk lain. Sesi dengan persetujuan otomatis penuh naik dari sekitar 20% pada pengguna baru menjadi lebih dari 40% setelah 750 sesi. Pada saat yang sama, porsi giliran yang mereka interupsi naik dari 5% menjadi sekitar 9%. Mereka berhenti menjaga setiap pintu, lalu mulai berpatroli.
Supaya pola itu aman, beri pengguna dua hal yang disarankan Anthropic kepada pengembang produk:
visibilitas yang bisa dipercaya tentang apa yang sedang dikerjakan agen, misalnya jejak OpenTelemetry dari topik Evals & Observability;
mekanisme intervensi yang sederhana untuk menghentikan atau mengarahkan ulang agen di tengah jalan.
Lalu ukur pengawasanmu seperti fitur lain:
Ukuran
Tanda bahaya
porsi permintaan yang disetujui
mendekati 100% bisa berarti pertanyaannya tak lagi dibaca
pertanyaan per sesi
terus naik saat tool baru ditambah
waktu sampai keputusan
sangat singkat untuk aksi besar
persetujuan yang kedaluwarsa
banyak berarti pengguna tak tahu ada yang menunggu
aksi tercatat yang dibatalkan kemudian
tingkat "catat" mungkin terlalu longgar
Sesekali, uji alurnya dengan permintaan yang seharusnya ditolak, dan lihat apakah penolakan itu sungguh terjadi. Pertanyaan yang tak pernah dijawab "tidak" patut dicurigai.
Tonton di YouTubeCara kerja pengklasifikasi yang menyaring setiap aksi menggantikan persetujuan manual, kenapa Claude tak pernah menyetujui aksinya sendiri, dan cara mengaturnya (6 menit, Agustus 2026).Sumber: Claude di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
SDK resmi untuk Messages API Claude di Python: tipe untuk definisi tool, blok tool_use dan tool_result, serta Tool Runner (beta) yang memutar putaran agen sendiri.
Dipakai untuk putaran yang bisa dijeda dan dilanjutkan di langkah 5 sampai 7, diuji dengan model tiruan lewat transport HTTP.
SDK resmi untuk membangun agen di atas harness Claude Code: tool bawaan, aturan izin, mode izin, hook, callback persetujuan canUseTool, dan pertanyaan klarifikasi AskUserQuestion.
Dibahas di langkah 8, 9, dan 11: pilihan jawaban persetujuan, AskUserQuestion, dan keputusan defer untuk jeda yang panjang.
Kerangka kerja sumber terbuka untuk agen berbentuk graf, dengan memori jangka pendek per thread lewat checkpointer dan memori jangka panjang per namespace lewat store.
Dipakai di langkah 10: interrupt() dan Command(resume=...) dengan checkpointer, termasuk aturan bahwa node diulang dari awal saat dilanjutkan.
04
Mini Project
Misi
Gerbang persetujuan yang bisa ditinggal tidur
Ambil agen perpustakaan dari proyek Tool use dan beri ia alur persetujuan yang sungguh dipakai: anggota menerima pertanyaan, menjawab kapan saja, dan agen melanjutkan dari tempatnya berhenti.
Simpan keadaan yang menunggu di basis data atau berkas, bukan di memori proses.
Tampilkan pertanyaan di antarmuka sederhana, misalnya halaman web atau perintah CLI, dengan tombol setuju, tolak, dan ubah lama pinjam.
Kamu selesai bila:
uji membuktikan proses yang berbeda bisa melanjutkan sesi yang dijeda, dan pinjaman tercatat tepat sekali;
ketika model meminta beberapa tool dalam satu giliran, semua tool_result-nya dikirim dalam satu pesan, urut sesuai tool_use;
ringkasan persetujuan disusun kode dari argumen dan katalog, dan uji membuktikan teks model tak pernah ikut tampil;
penolakan sampai ke model sebagai is_error berisi alasan pengguna, dan tak ada jawaban berarti tolak;
persetujuan kedaluwarsa setelah batas yang kamu tetapkan, dan syarat aksi dicek ulang saat dijalankan, dengan uji merah yang menunjukkan apa yang terjadi tanpanya;
setiap keputusan masuk jejak audit yang bisa kamu cari menurut anggota dan tanggal.
Misi
Kurangi pertanyaan tanpa mengurangi keamanan
Proyek kedua menguji keseimbangan yang dibahas di halaman ini. Siapkan 30 sesi skenario, campuran pertanyaan, peminjaman, perpanjangan, dan beberapa permintaan yang seharusnya ditolak, termasuk injeksi dari topik Keamanan agen.
Jalankan semuanya dengan kebijakan "tanya semua", lalu dengan kebijakan bertingkat milikmu.
Catat untuk setiap kebijakan: jumlah pertanyaan, aksi yang dicatat otomatis, dan aksi berbahaya yang lolos.
Kamu selesai bila:
tabel perbandingan kedua kebijakan tersedia untuk ke-30 sesi;
kebijakan bertingkat mengajukan jauh lebih sedikit pertanyaan, dan kamu menyebut angkanya;
tak satu pun aksi berbahaya lolos di kebijakan bertingkat, dibuktikan dengan uji;
tool yang tak terdaftar ditolak secara bawaan, dibuktikan dengan uji;
kamu menuliskan satu aksi yang tingkatnya kamu ubah setelah melihat data, beserta alasannya.