Large Language Model (LLM) adalah mesin di balik Claude dan asisten AI lainnya. Cara kerjanya mengejutkan sederhana: ia menebak potongan teks berikutnya, satu per satu, berdasarkan semua yang sudah ada sebelumnya. Kemampuan menulis, merangkum, menerjemahkan, dan bernalar muncul dari tebakan berulang itu, setelah model dilatih pada teks dalam jumlah sangat besar dan kemudian diajari bersikap sebagai asisten. Di halaman ini kamu membedah LLM dari dalam: token dan Byte Pair Encoding, embedding, atensi dan Transformer, pretraining dan hukum penskalaan, fine-tuning dan RLHF, cara teks dihasilkan lewat sampling, sampai hal-hal praktis ketika memakai Claude hari ini: effort dan thinking, jendela konteks, biaya per token, dan batas-batas model. Setiap konsep diantar contoh kode kecil yang bisa kamu jalankan sendiri tanpa memanggil API berbayar.
Penebak kata yang sangat terlatih
Pernah memperhatikan papan ketik ponsel yang menebak kata berikutnya? Ketik "selamat", dan ia menawarkan "pagi" atau "ulang tahun". LLM melakukan hal yang sama, hanya dalam skala yang jauh lebih besar. Ia membaca semua teks yang sudah ada, lalu memberi peluang untuk setiap potongan teks yang mungkin muncul berikutnya. Satu potongan dipilih, ditambahkan ke teks, lalu prosesnya diulang.
Glosarium dokumentasi Claude menyebut tahap pertama pembentukan model seperti ini pretraining: model dilatih pada korpus teks besar tanpa label untuk menebak kata berikutnya dari konteks sebelumnya. Hasilnya belum pandai menjawab pertanyaan atau mengikuti instruksi. Ia baru menjadi asisten setelah tahap-tahap berikutnya, fine-tuning dan RLHF.
Lalu bagaimana menebak kata bisa menghasilkan esai, kode, dan penalaran? Salah satu cara memahaminya: supaya tebakannya bagus untuk teks apa pun, model perlu menangkap banyak pola dari bahasa dan dunia: tata bahasa, fakta, gaya penulisan, bahkan langkah-langkah logika. Semua itu tersimpan sebagai parameter, angka-angka yang disetel selama pelatihan. Glosarium Claude menyebut LLM sebagai model bahasa dengan banyak parameter yang mampu mengerjakan beragam tugas yang ternyata sangat berguna.
Perjalanan sebuah kalimat
Ketika kamu mengirim pertanyaan ke Claude, teksmu melewati beberapa tahap. Setiap tahap punya langkahnya sendiri di bawah:
Tahap
Yang terjadi
Langkah
Tokenisasi
teks dipecah menjadi token, potongan kecil yang dikenal model
2
Embedding
setiap token diubah menjadi deretan angka (vektor)
3
Atensi
setiap token "melihat" token-token sebelumnya untuk memahami konteks
4
Transformer
atensi dan lapisan lain ditumpuk berkali-kali
5
Peluang
model menghasilkan peluang untuk setiap token berikutnya
1, 8
Sampling
satu token dipilih, ditambahkan, lalu proses diulang
8
Tonton di YouTubePengantar ringan tentang LLM, chatbot, pretraining, dan Transformer, dibuat untuk pameran di Computer History Museum (8 menit, November 2024).Sumber: 3Blue1Brown di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
Kenapa memahami bagian dalamnya?
Kamu tak perlu membangun LLM sendiri untuk memakainya. Tetapi memahami cara kerjanya menjelaskan banyak hal yang akan kamu temui sehari-hari:
kenapa harga dan batas dihitung dalam token, bukan kata;
kenapa jawaban bisa berbeda walau pertanyaannya sama;
kenapa model bisa "berhalusinasi" dengan sangat meyakinkan;
kenapa konteks yang terlalu panjang bisa menurunkan ketelitian.
Halaman ini juga menjadi fondasi bidang AI Agents. Tool use, memori, dan keamanan agen semuanya dibangun di atas satu kemampuan dasar: menebak token berikutnya dengan sangat baik.
Catatan
Beberapa hal tentang model Claude terbaru berbeda dari yang sering diajarkan di tutorial lama. Contohnya, parameter temperature tak lagi bisa diubah di model terbaru. Langkah 9 membahasnya, dan semua fakta tentang Claude di halaman ini diambil dari dokumentasi resminya.
02
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: Python, peluang, dan sedikit aljabar linear
Sebelum mulai, pastikan hal-hal ini sudah akrab bagimu:
Python 3.10 atau lebih baru, dan sedikit NumPy: membuat larik, perkalian matriks dengan @, dan fungsi seperti np.exp.
Peluang dasar: peluang bernilai 0 sampai 1, dan peluang semua kemungkinan berjumlah 1. Logaritma natural (ln) dipakai di langkah 1.
Vektor dan matriks: vektor adalah deretan angka, dan perkalian dua vektor (dot product) mengukur seberapa searah keduanya.
Tak perlu latar belakang machine learning. Setiap istilah dijelaskan saat pertama muncul, dan tak perlu kunci API untuk menjalankan contohnya.
1
Rasakan tugas intinya: menebak token berikutnya
Cara terbaik memahami LLM adalah membuat versi paling kecilnya. Model bigram menebak kata berikutnya hanya dari satu kata sebelumnya, dengan menghitung seberapa sering pasangan kata muncul di korpus:
python
def peluang(model: dict[str, Counter[str]], sebelum: str, sesudah: str, kosakata: int) -> float:
    c = model.get(sebelum, Counter())
    return (c[sesudah] + 1) / (sum(c.values()) + kosakata)  # +1 supaya kata baru tak berpeluang 0


def loss(model: dict[str, Counter[str]], kalimat: str, kosakata: int) -> float:
    """Rata-rata -ln p(kata berikutnya). Inilah yang diturunkan selama pretraining."""
    kata = ["<awal>"] + kalimat.lower().split() + ["<akhir>"]
    nilai = [-math.log(peluang(model, a, b, kosakata)) for a, b in zip(kata, kata[1:])]
    return sum(nilai) / len(nilai)
Fungsi loss menghitung rata-rata −ln dari peluang kata yang benar. Makin yakin model pada kata yang benar, makin kecil angkanya. Inilah besaran yang diturunkan selama pretraining LLM sungguhan, hanya dengan model jauh lebih besar dan teks jauh lebih banyak.
Kami melatihnya pada enam kalimat sederhana tentang perpustakaan. Kalimat wajar "saya ingin meminjam novel" mendapat loss 1,929, sedangkan versi acaknya, "novel meminjam ingin saya", mendapat 2,841. Model sudah "merasa" mana yang lebih masuk akal.
Ketika diminta menulis sendiri dengan selalu memilih kata paling mungkin, ia menghasilkan "saya ingin meminjam buku di perpustakaan". Kalimat itu tak ada di korpusnya; model menyambung potongan dari kalimat-kalimat lain. Benih kemampuan menulis sudah terlihat, tetapi bigram tak punya ingatan lebih dari satu kata. Langkah-langkah berikutnya mengatasi keterbatasan itu.
2
Pecah teks menjadi token
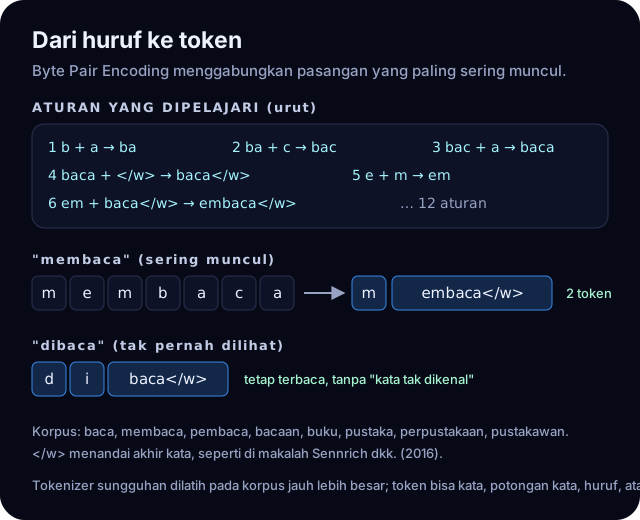
Model tak membaca huruf atau kata secara langsung, melainkan token. Glosarium Claude menjelaskan bahwa token bisa berupa kata, potongan kata, huruf, bahkan byte. Cara memecahnya yang populer adalah Byte Pair Encoding (BPE), yang diperkenalkan untuk model bahasa oleh Sennrich dkk. (2016): mulai dari huruf, lalu berulang kali gabungkan pasangan simbol yang paling sering muncul.
python
def latih_bpe(korpus: dict[str, int], n_gabung: int) -> list[tuple[str, str]]:
    """korpus: kata -> frekuensi. Setiap kata dipecah per huruf, ditambah penanda akhir kata '</w>'."""
    kata = {tuple(k) + ("</w>",): f for k, f in korpus.items()}
    aturan: list[tuple[str, str]] = []
    for _ in range(n_gabung):
        pasangan: Counter[tuple[str, str]] = Counter()
        for simbol, f in kata.items():
            for a, b in zip(simbol, simbol[1:]):
                pasangan[(a, b)] += f
        if not pasangan:
            break
        terbaik = max(pasangan, key=lambda p: pasangan[p])  # seri: yang pertama ditemukan
        aturan.append(terbaik)
        kata = {_gabung(s, terbaik): f for s, f in kata.items()}
    return aturan
Aturan yang dihasilkannya sama persis dengan algoritma rujukan di makalah itu.
Aturan dan hasil pemecahan dari contoh kode di langkah 2.Lisensi: Karya sendiri
Kata yang sering muncul akhirnya menjadi satu token utuh, sedangkan kata langka dipecah menjadi potongan. Karena itu tak ada kata yang benar-benar "tak dikenal".
Bagi pengguna Claude, ada dua hal praktis:
Perkiraan kasar bisa usang. Glosarium menyebut satu token kira-kira 3,5 karakter bahasa Inggris. Tetapi dokumentasi token counting mencatat bahwa tokenizer yang diperkenalkan bersama Claude Opus 4.7 menghitung prompt yang sama kira-kira 30% lebih banyak daripada model sebelumnya.
Hitung dengan API, jangan menebak. Endpoint penghitung token gratis (tetap dibatasi jumlah permintaan per menit), dan hasilnya mengikuti tokenizer model yang kamu sebut. Angkanya perkiraan, tetapi jauh lebih tepat daripada rumus kasar.
3
Ubah token menjadi vektor: embedding
Model hanya bisa menghitung dengan angka. Karena itu setiap token diubah menjadi embedding, yaitu vektor berisi ratusan sampai ribuan angka. Makalah Attention Is All You Need (Vaswani dkk., 2017), yang memperkenalkan arsitektur Transformer, menyebutnya learned embeddings. Angka-angka itu tak ditentukan manusia, melainkan disetel selama pelatihan.
Hasilnya, token yang maknanya mirip cenderung punya vektor yang berdekatan.
Ada satu masalah. Atensi, yang dibahas di langkah berikutnya, tak punya rasa urutan bawaan: "anjing menggigit orang" dan "orang menggigit anjing" berisi token yang sama. Makalah itu menjelaskan bahwa, karena modelnya tak memakai rekurensi maupun konvolusi, informasi posisi harus disuntikkan ke embedding. Caranya dengan menambahkan positional encoding, vektor posisi berdimensi sama dengan embedding.
Jadi setiap token masuk ke model sebagai satu vektor yang membawa dua hal: apa token itu, dan di mana letaknya.
4
Atensi: setiap token melihat token lain
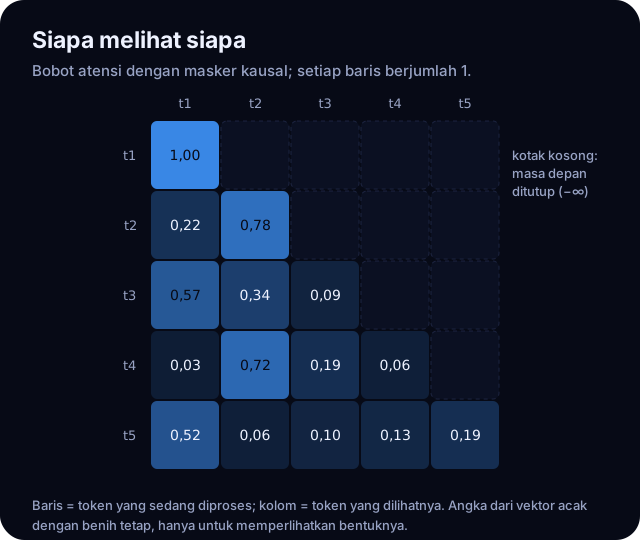
Kata "bisa" berarti lain dalam "ular itu bisa" dan "saya bisa datang". Untuk memahami sebuah token, model perlu melihat token-token di sekitarnya. Itulah atensi. Setiap token membuat tiga vektor: query (Q, apa yang sedang kucari), key (K, apa yang kutawarkan), dan value (V, isi yang kuberikan). Rumusnya softmax(QKᵀ / √d_k) · V:
python
def atensi(Q: Matriks, K: Matriks, V: Matriks, kausal: bool = True) -> tuple[Matriks, Matriks]:
    d_k = Q.shape[-1]
    skor = Q @ K.T / np.sqrt(d_k)              # seberapa relevan token j bagi token i
    if kausal:                                 # token i tak boleh melihat token sesudahnya
        skor = np.where(np.triu(np.ones_like(skor), k=1) == 1, -np.inf, skor)
    bobot = softmax(skor)                      # setiap baris berjumlah 1
    return bobot @ V, bobot
Bobot dari contoh kode di langkah 4, dengan vektor acak berbenih tetap.Lisensi: Karya sendiri
Dua detail di kode itu berasal langsung dari makalah Transformer:
Dibagi √d_k. Untuk dimensi besar, hasil perkalian titik bisa sangat besar sehingga softmax masuk ke wilayah dengan gradien sangat kecil. Bila komponen q dan k acak dengan rata-rata 0 dan ragam 1, ragam hasil kalinya sama dengan d_k. Kami memeriksanya: untuk d_k = 64, ragamnya 64,6, dan sesudah dibagi √64 menjadi 1,01.
Masker kausal. Model penulis tak boleh mengintip token sesudahnya. Makalah itu menutup hubungan yang dilarang dengan mengisinya −∞ sebelum softmax, sehingga bobotnya tepat nol.
Setiap baris bobot berjumlah 1. Keluaran setiap token adalah rata-rata berbobot dari value token-token yang boleh dilihatnya.
Tonton di YouTubeAtensi dijelaskan langkah demi langkah dengan animasi: pola atensi, masker, multi-head, dan jumlah parameter (26 menit, April 2024).Sumber: 3Blue1Brown di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
5
Tumpuk menjadi Transformer
Satu lapisan atensi belum cukup. Transformer menumpuk lapisan yang sama berkali-kali. Di makalah aslinya, setiap tumpukan terdiri dari 6 lapisan identik, dan setiap lapisan punya dua bagian:
Multi-head attention: beberapa atensi berjalan berdampingan. Makalahnya menjelaskan bahwa ini memungkinkan model memperhatikan informasi dari berbagai sudut pandang sekaligus, sesuatu yang tak bisa dilakukan satu kepala atensi karena hasilnya dirata-ratakan.
Jaringan feed-forward yang diterapkan pada setiap posisi.
Di sekitar setiap bagian ada sambungan residual: masukan ditambahkan kembali ke keluaran sebelum dinormalisasi. Dengan begitu informasi bisa mengalir melewati banyak lapisan tanpa hilang.
Di ujung tumpukan, vektor terakhir diubah menjadi peluang untuk setiap token di kosakata, lewat transformasi linear dan softmax. Dari situlah langkah 8 memilih token berikutnya.
Kenapa Transformer mengalahkan pendahulunya? Abstrak makalah itu menyebut dua keunggulan: kualitasnya lebih baik, dan pelatihannya jauh lebih mudah diparalelkan sehingga butuh waktu jauh lebih singkat. Model-model berbasis rekurensi memproses token satu per satu. Transformer memproses semua token dalam sebuah teks latihan sekaligus, dan kemampuan itulah yang memungkinkan pelatihan pada teks berskala sangat besar.
6
Pretraining dan hukum penskalaan
Seberapa besar model harus dibuat, dan berapa banyak teks yang perlu dibaca? Kaplan dkk. (2020) menemukan pola yang mengejutkan rapi: loss model bahasa turun mengikuti hukum pangkat (power law) terhadap ukuran model, jumlah data, dan jumlah komputasi pelatihan. Beberapa tren itu bertahan lebih dari tujuh orde besaran. Detail arsitektur, seperti lebar atau kedalaman jaringan, ternyata berpengaruh kecil dalam rentang yang luas.
Temuan itu membuat banyak tim memperbesar model sambil mempertahankan jumlah data. Hoffmann dkk. (2022) kemudian menunjukkan bahwa banyak model besar saat itu sebenarnya kurang dilatih. Setelah melatih lebih dari 400 model, mereka menyimpulkan bahwa untuk anggaran komputasi tertentu, ukuran model dan jumlah token latihan sebaiknya dinaikkan seimbang: setiap kali ukuran model digandakan, jumlah token latihan juga digandakan.
Untuk membuktikannya, mereka melatih Chinchilla, model 70 miliar parameter dengan anggaran komputasi yang sama dengan Gopher (280 miliar parameter) tetapi dengan data empat kali lebih banyak. Chinchilla mengungguli Gopher dan model lain yang jauh lebih besar di banyak tugas. Model yang lebih kecil juga lebih murah dipakai sesudahnya.
Pelajaran untukmu sebagai pengguna: ukuran model bukan satu-satunya ukuran mutu. Data, cara melatih, dan tahap-tahap sesudah pretraining sama pentingnya.
7
Dari model dasar ke asisten
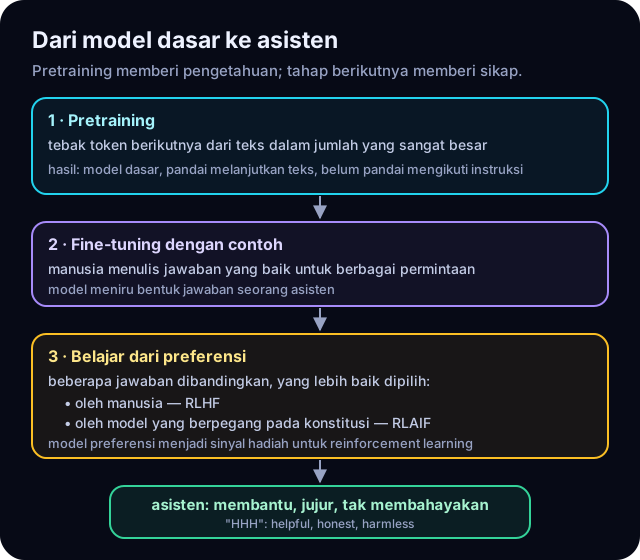
Model hasil pretraining pandai melanjutkan teks, tetapi belum tentu menuruti maksudmu. Ouyang dkk. (2022) menulis bahwa membuat model lebih besar tak otomatis membuatnya lebih baik dalam mengikuti maksud pengguna. Model besar bisa menghasilkan jawaban yang tak benar, kasar, atau sekadar tak membantu.
Ringkasan dari glosarium Claude, Ouyang dkk. (2022), dan Bai dkk. (2022).Lisensi: Karya sendiri
Jalan keluarnya adalah dua tahap tambahan:
Fine-tuning dengan contoh: manusia menulis contoh jawaban yang baik, lalu model dilatih menirunya.
Belajar dari preferensi: model menghasilkan beberapa jawaban, lalu manusia mengurutkannya. Glosarium Claude menjelaskan bahwa reinforcement learning from human feedback (RLHF) mendorong model memilih keluaran yang mirip dengan jawaban berperingkat tinggi.
Hasilnya mencolok. Dalam penilaian manusia, jawaban InstructGPT berukuran 1,3 miliar parameter lebih disukai daripada jawaban GPT-3 berukuran 175 miliar parameter, padahal parameternya 100 kali lebih sedikit.
Anthropic mengembangkan dua cara dalam keluarga ini. Bai dkk. (2022) melatih asisten yang membantu sekaligus tak membahayakan dengan RLHF. Constitutional AI (Bai dkk., 2022) mengganti sebagian penilaian manusia dengan model yang berpegang pada sekumpulan prinsip tertulis, sebuah "konstitusi". Cara ini disebut RLAIF, reinforcement learning from AI feedback. Tujuan bersamanya dirangkum glosarium Claude sebagai HHH: helpful, honest, harmless (membantu, jujur, tak membahayakan).
8
Cara teks dihasilkan: sampling
Di ujung Transformer, model memberi skor (logit) untuk setiap token. Skor diubah menjadi peluang dengan softmax, lalu satu token dipilih. Cara memilihnya ternyata sangat menentukan mutu teks:
python
def peluang(logit: Vektor, suhu: float = 1.0) -> Vektor:
    z = logit / suhu                  # suhu < 1 menajamkan, suhu > 1 meratakan
    e = np.exp(z - z.max())
    hasil: Vektor = e / e.sum()
    return hasil


def nukleus(p: Vektor, top_p: float) -> Vektor:
    """Simpan himpunan terkecil kata teratas yang peluang totalnya >= top_p, lalu normalkan lagi."""
    urut = np.argsort(-p)
    kumulatif = np.cumsum(p[urut])
    batas = int(np.searchsorted(kumulatif, top_p)) + 1
    q = np.zeros_like(p)
    q[urut[:batas]] = p[urut[:batas]]
    return q / q.sum()
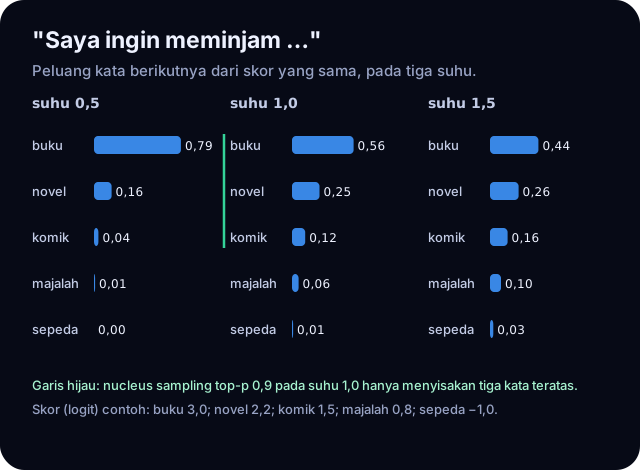
Angka dari contoh kode di langkah 8.Lisensi: Karya sendiri
Untuk skor contoh sesudah "Saya ingin meminjam", peluang "buku" adalah 0,79 pada suhu 0,5, 0,56 pada suhu 1,0, dan 0,44 pada suhu 1,5. Suhu (temperature) rendah menajamkan pilihan; suhu tinggi meratakannya. Glosarium Claude menjelaskan bahwa suhu tinggi memberi keluaran yang lebih beragam dan kreatif, sedangkan suhu rendah lebih konservatif.
Kenapa tidak selalu memilih token paling mungkin? Holtzman dkk. (2019) menemukan bahwa memaksimalkan peluang justru menghasilkan teks yang hambar dan anehnya berulang-ulang. Mereka mengusulkan nucleus sampling (top-p): ambil himpunan terkecil token teratas yang peluang totalnya mencapai p, lalu pilih secara acak dari situ. Pada contoh kita, top-p 0,9 hanya menyisakan "buku", "novel", dan "komik". Ekor distribusi yang tak bisa diandalkan, seperti "sepeda", dibuang.
Langkah berikutnya menjelaskan bagaimana semua ini terlihat ketika kamu memakai Claude hari ini.
9
Di API Claude hari ini: effort, bukan temperature
Banyak tutorial menyarankan mengatur temperature. Untuk model Claude terbaru, saran itu sudah tak berlaku. Dokumentasi thinking menyebutkan bahwa pada Claude Fable 5.1, Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 5.5, dan beberapa model lain, nilai temperature, top_p, atau top_k selain bawaannya menghasilkan galat 400 di setiap permintaan. Referensi API menandai ketiganya deprecated untuk model yang dirilis sesudah Claude Opus 4.6.
Sebagai gantinya, kendali utamanya adalah effort:
python
def tanya(client: anthropic.Anthropic, pertanyaan: str, effort: Effort = "low") -> tuple[str, Usage]:
    respons = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=2048,
        output_config={"effort": effort},  # bukan temperature: model terbaru menolaknya
        messages=[{"role": "user", "content": pertanyaan}],
    )
    teks = "".join(b.text for b in respons.content if b.type == "text")  # lewati blok thinking
    return teks, respons.usage
Effort memengaruhi semua token keluaran: teks, panggilan tool, dan thinking. Ada lima tingkatnya, low, medium, high, xhigh, dan max. Bawaannya medium pada Claude Opus 5.5 dan Claude Haiku 5.5, dan high pada model lain. Pada Claude Opus 5.5, adaptive thinking selalu aktif, yaitu model memutuskan sendiri seberapa banyak berpikir sebelum menjawab, sehingga effort menjadi kendali utama atas kedalaman penalaran dan biaya. Dokumentasinya menyarankan menguji beberapa tingkat effort pada eval-mu sendiri, bukan menyalin pengaturan dari model lama.
Satu hal lagi dari glosarium: bahkan dengan temperature 0 pada model lama, keluaran API tak sepenuhnya deterministik. Jangan membangun aplikasi yang bergantung pada jawaban yang persis sama setiap kali.
10
Jendela konteks: memori kerja model
Model tak mengingat percakapan di antara panggilan. Yang ia "lihat" hanyalah isi jendela konteks saat itu. Dokumentasi Claude menyebutnya memori kerja model, berbeda dari korpus besar yang dipakai untuk melatihnya.
Semua yang ada di permintaan dihitung masuk jendela itu: prompt sistem, setiap pesan (termasuk hasil tool, gambar, dan dokumen), definisi tool, dan juga keluaran yang sedang ditulis model, termasuk thinking. Untuk model Claude terbaru, jendelanya 1 juta token, dan satu permintaan bisa menghasilkan sampai 128 ribu token keluaran.
Besar bukan berarti boleh diisi sembarangan. Dokumentasi yang sama memperingatkan context rot: makin banyak token di konteks, makin turun ketelitian dan kemampuan model mengingat isinya. Karena itu memilih apa yang dimasukkan ke konteks sama pentingnya dengan seberapa besar ruangnya. Topik Memori agen membahas cara-cara mengelolanya, seperti compaction dan context editing.
Satu hal praktis lagi: setiap respons API melaporkan pemakaian token di medan usage. Biasakan membacanya. Angka itulah dasar biaya dan batas yang dibahas di langkah berikutnya.
11
Biaya per token dan memilih model
Harga LLM dihitung per token, dengan harga berbeda untuk token masukan dan keluaran. Tabel Models overview di dokumentasi Claude mencantumkan, misalnya:
Model
Masukan per juta token
Keluaran per juta token
Kecepatan relatif
Claude Fable 5.1
$10
$50
lebih lambat
Claude Opus 5.5
$4
$20
sedang
Claude Sonnet 5.5
$2
$10
cepat
Claude Haiku 5.5
mulai $0,10
mulai $0,50
paling cepat
Menghitung biayanya tinggal mengalikan usage dengan harga:
python
HARGA_PER_JUTA = {  # USD per juta token, dari tabel Models overview dokumentasi Claude
    "claude-opus-5-5": {"masuk": 4.00, "keluar": 20.00},
    "claude-sonnet-5-5": {"masuk": 2.00, "keluar": 10.00},
}


def biaya(model: str, input_tokens: int, output_tokens: int) -> float:
    h = HARGA_PER_JUTA[model]
    return input_tokens / 1_000_000 * h["masuk"] + output_tokens / 1_000_000 * h["keluar"]
Permintaan dengan 2.000 token masukan dan 500 token keluaran berbiaya $0,018 di Claude Opus 5.5 dan $0,009 di Claude Sonnet 5.5.
Dokumentasi yang sama menyarankan mulai dari Claude Opus 5.5 untuk kebanyakan pekerjaan. Claude Fable 5.1 untuk penalaran yang sangat menuntut dan pekerjaan agen jangka panjang. Claude Haiku 5.5 untuk tugas bervolume tinggi yang butuh respons cepat, seperti klasifikasi, ekstraksi, dan perutean. Ada juga cara menghemat: Batch API memberi potongan 50%, dan token yang dibaca dari cache prompt jauh lebih murah daripada token masukan biasa.
12
Kenali batasnya
Memahami cara kerja LLM juga berarti memahami di mana ia bisa salah. Ada empat batas penting:
Pengetahuan berhenti di satu titik. Model hanya tahu apa yang ada di data latihnya. Dokumentasi Claude mencantumkan reliable knowledge cutoff, tanggal sampai mana pengetahuan model paling luas dan bisa diandalkan; untuk model Claude terbaru, Juni 2026. Untuk informasi sesudahnya atau data pribadimu, berikan lewat konteks.
Halusinasi. Model dilatih menghasilkan teks yang masuk akal, dan teks yang masuk akal belum tentu benar. Karena itu "jujur", yaitu memberi informasi akurat tanpa mengarang dan mengakui ketidakpastian, menjadi salah satu tujuan HHH. Untuk fakta penting, beri model sumber dan minta ia merujuknya.
Tak sepenuhnya deterministik. Pertanyaan yang sama bisa menghasilkan jawaban berbeda. Uji aplikasimu dengan banyak percobaan, seperti dibahas topik Evals & Observability.
Konteks bukan gudang. Makin penuh, makin besar risiko context rot.
Kabar baiknya, sebagian besar batas ini bisa diatasi dengan desain aplikasi, bukan dengan model yang lebih besar. Retrieval augmented generation (RAG) memasukkan dokumen yang relevan ke konteks saat dibutuhkan. Tool use membiarkan model mengambil data terbaru atau menghitung dengan tepat. Dari sinilah bidang AI Agents dimulai.
Tonton di YouTubeKuliah panjang Andrej Karpathy tentang seluruh tahap pembuatan LLM, dari pretraining sampai reinforcement learning (3,5 jam, Februari 2025).Sumber: Andrej Karpathy di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
SDK resmi untuk Messages API Claude di Python: tipe untuk definisi tool, blok tool_use dan tool_result, serta Tool Runner (beta) yang memutar putaran agen sendiri.
Dipakai di langkah 9 untuk permintaan dengan output_config.effort, dan di proyek kedua untuk menghitung token.
Pustaka sumber terbuka untuk komputasi numerik di Python: larik berdimensi banyak, perkalian matriks, dan fungsi matematika yang cepat.
Dipakai di langkah 4 dan 8 untuk atensi dan sampling, dan di proyek pertama untuk membangun Transformer mini.
04
Mini Project
Misi
Model bahasa mini dari nol
Bangun model bahasa kecilmu sendiri, mulai dari bigram sampai Transformer mini, dan latih pada teks berbahasa Indonesia yang bebas dipakai.
Pakai NumPy atau PyTorch. Kerangka seperti nanoGPT boleh dijadikan rujukan, tetapi tulis tokenizer dan atensinya sendiri.
Sisihkan sebagian teks sebagai data uji yang tak pernah dipakai melatih.
Kamu selesai bila:
tokenizer BPE-mu dilatih pada korpusmu, dan uji membuktikan setiap kata di data uji bisa dipecah tanpa simbol asing;
atensimu lolos uji: setiap baris bobot berjumlah 1, dan bobot ke token sesudahnya tepat 0;
loss di data uji turun selama pelatihan, dan kamu membandingkannya dengan loss model bigram pada data yang sama;
sampling mendukung suhu dan top-p, dan kamu menyimpan contoh teks pada tiga pengaturan yang berbeda;
kamu menjelaskan satu kesalahan khas modelmu dari contoh keluarannya.
Misi
Token, biaya, dan effort untuk aplikasimu
Proyek kedua melatih kebiasaan praktis seorang pembangun aplikasi LLM. Siapkan 10 prompt yang mewakili aplikasimu, sebagian berbahasa Indonesia dan sebagian berbahasa Inggris.
Hitung tokennya dengan endpoint penghitung token Claude, yang gratis.
Jalankan prompt-prompt itu pada dua tingkat effort, misalnya low dan medium, lalu catat usage setiap respons.
Kamu selesai bila:
tabelmu memuat jumlah karakter, jumlah token, dan karakter per token untuk setiap prompt, dan kamu membandingkan bahasa Indonesia dengan bahasa Inggris;
biaya setiap permintaan dihitung dari usage dan harga di dokumentasi;
kamu membandingkan mutu dan biaya kedua tingkat effort, lalu memilih satu dengan alasan yang jelas;
kodemu tak pernah mengirim temperature, top_p, atau top_k selain bawaan ke model yang menolaknya.