Deep learning adalah cara mengajari komputer lewat contoh, bukan lewat aturan yang ditulis tangan. Jaringan saraf tiruan, yaitu tumpukan lapisan berisi neuron-neuron kecil, menyetel bobotnya sedikit demi sedikit setiap kali tebakannya keliru, sampai ia menemukan sendiri pola di dalam data. Inilah fondasi pengenalan gambar, pengenalan suara, dan Large Language Model seperti Claude. Di halaman ini kamu membangunnya dari bawah: satu neuron, kenapa jaringan harus berlapis, loss sebagai ukuran salah, gradient descent dan rambat balik (backpropagation), lalu melatih jaringan pertamamu dengan NumPy sebelum pindah ke PyTorch. Sesudah itu kamu belajar membaca kurva latih dan validasi, melawan overfitting, memahami trik yang membuat jaringan sangat dalam bisa dilatih, memilih arsitektur yang cocok, dan mengikuti resep latihan para praktisi. Setiap contoh kode sudah dijalankan dan bisa kamu jalankan sendiri di laptop biasa, tanpa GPU dan tanpa biaya.
Pustakawan yang belajar dari contoh
Bayangkan seorang pustakawan baru yang ditugasi memilah buku kembalian: mana yang perlu diperbaiki dulu sebelum kembali ke rak. Tak ada buku panduan. Seniornya hanya berkata "yang ini benar" atau "yang itu keliru" untuk setiap buku yang ia pilah. Awalnya tebakannya asal-asalan. Tetapi setiap koreksi menggeser kebiasaannya sedikit: lebih memperhatikan punggung buku yang retak, lebih mengabaikan sampul yang sekadar kusam. Setelah ribuan buku, ia memilah dengan baik, padahal tak seorang pun pernah menuliskan aturannya.
Deep learning bekerja dengan cara yang sama. Dalam ulasan mereka di jurnal Nature (2015), LeCun, Bengio, dan Hinton menjelaskannya sebagai model yang tersusun dari banyak lapisan pemrosesan, yang belajar mewakili data dengan banyak tingkat abstraksi. Algoritme rambat balik (backpropagation) memberi tahu bagaimana setiap parameter di dalamnya harus diubah, persis seperti koreksi dari sang senior.
Peta perjalanan
Bagian
Pertanyaan yang dijawab
Langkah
Bahan dasar
apa itu neuron, dan kenapa jaringan harus berlapis
1–2
Cara belajar
bagaimana mengukur kesalahan, lalu memperbaikinya
3–6
Praktik
menulis putaran latihan dengan PyTorch dan memakai data dengan jujur
7–8
Menjaga mutu
overfitting, regularisasi, dan jaringan yang sangat dalam
9–10
Wawasan
memilih arsitektur, resep latihan, dan batas-batasnya
11–12
Tonton di YouTubeNeuron, lapisan, bobot, dan bias dijelaskan dengan animasi, memakai contoh pengenal angka tulisan tangan (19 menit, Oktober 2017).Sumber: 3Blue1Brown di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
Hubungannya dengan topik lain
Deep learning adalah fondasi bidang ini. Transformer, mesin di balik setiap LLM, adalah jaringan saraf yang dilatih dengan gradient descent dan rambat balik, persis seperti yang kamu pelajari di sini, hanya jauh lebih besar. Begitu pula model pengenal gambar dan suara. Topik Large Language Model melanjutkan cerita dari titik ini.
Catatan
Semua angka di halaman ini, dari loss, akurasi, sampai gradien, berasal dari kode yang benar-benar dijalankan dengan PyTorch 2.14.1 dan NumPy 2.5.3 di CPU laptop biasa. Benih acaknya tetap, tetapi angka di mesinmu bisa sedikit berbeda. Polanya akan sama.
02
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: Python, NumPy, dan sedikit kalkulus
Sebelum mulai, pastikan hal-hal ini sudah akrab bagimu:
Python 3.10 atau lebih baru, dan dasar NumPy: membuat larik, perkalian matriks dengan @, dan fungsi seperti np.exp dan np.maximum.
Turunan sebagai kemiringan: bila turunan sebuah fungsi positif, nilainya naik ketika masukannya digeser ke kanan. Aturan rantai akan dijelaskan ulang di langkah 5.
Vektor dan matriks: deretan angka, dan cara mengalikannya.
Tak perlu GPU dan tak perlu kunci API. Semua contoh berjalan di CPU dalam hitungan detik sampai satu menit. Pasang PyTorch dengan pip install torch sebelum langkah 7.
1
Satu neuron: kalikan, jumlahkan, lalu putuskan
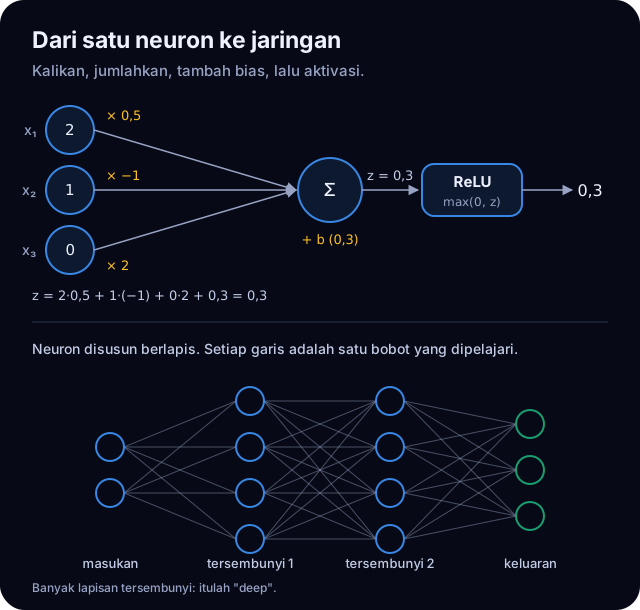
Neuron tiruan diilhami sel saraf secara longgar, tetapi pekerjaannya sederhana. Setiap masukan dikalikan dengan bobot, yaitu seberapa penting masukan itu. Hasilnya dijumlahkan, ditambah bias (kecenderungan dasar neuron), lalu dilewatkan fungsi aktivasi yang memutuskan keluarannya.
python
def neuron(x: Larik, w: Larik, b: float) -> float:
    z = float(x @ w + b)  # jumlah berbobot, ditambah bias
    return max(0.0, z)  # aktivasi ReLU: negatif menjadi 0
Buku Goodfellow dkk. menyebut ReLU sebagai rekomendasi bawaan untuk jaringan modern: angka negatif menjadi 0, angka positif diteruskan apa adanya. Dengan masukan 2, 1, dan 0, bobot 0,5, −1, dan 2, serta bias 0,3, neuron ini menghitung z = 0,3 dan mengeluarkan 0,3.
Angka neuron dari contoh kode di langkah ini.Lisensi: Karya sendiri
Bobot dan bias disebut parameter. "Belajar" dalam deep learning berarti satu hal: mencari nilai parameter yang membuat tebakan jaringan benar. Jaringan sungguhan berisi sangat banyak neuron yang disusun berlapis. Lapisan di antara masukan dan keluaran disebut lapisan tersembunyi, dan jaringan disebut deep karena lapisan tersembunyinya banyak.
Makalah rambat balik Rumelhart, Hinton, dan Williams (1986) mencatat hal yang menarik: sesudah dilatih, unit-unit tersembunyi itu dengan sendirinya mewakili fitur-fitur penting dari tugasnya. Tak ada yang menyuruh mereka. Itulah yang membedakan deep learning dari program biasa.
2
Kenapa jaringan harus berlapis, dan kenapa butuh aktivasi
Bayangkan aturan rak pajangan di depan perpustakaan: buku dipajang bila ia baru atau populer, tetapi tidak keduanya, karena buku yang baru dan populer pasti laku tanpa dipajang. Dalam angka, ini fungsi XOR: jawabannya 1 bila tepat satu dari dua masukan bernilai 1.
Model linear, yang hanya menjumlahkan masukan berbobot, gagal total di sini. Buku Deep Learning karya Goodfellow, Bengio, dan Courville menghitungnya di bab 6: model linear terbaik mengeluarkan 0,5 untuk semua titik. Uji kami mendapat angka yang sama. Tak ada garis lurus yang bisa memisahkan keempat titik XOR.
Jalan keluarnya adalah lapisan tersembunyi dengan aktivasi. Buku yang sama memberi bobot yang tepat untuk jaringan dua lapis:
python
def xor_dua_lapis() -> Larik:
    # bobot dari buku Deep Learning (Goodfellow dkk.), bagian 6.1
    W = np.array([[1, 1], [1, 1]], dtype=np.float64)
    c = np.array([0, -1], dtype=np.float64)
    w = np.array([1, -2], dtype=np.float64)
    h = relu(X @ W + c)  # lapisan tersembunyi
    return h @ w + 0.0  # lapisan keluaran, b = 0
Hasilnya 0, 1, 1, 0, persis XOR. Lapisan tersembunyi mengubah "sudut pandang" terhadap data, sampai keempat titik bisa dipisahkan oleh lapisan berikutnya.
Kenapa aktivasi wajib ada? Tanpanya, dua lapisan linear yang ditumpuk hanyalah satu lapisan linear yang menyamar: W2 @ (W1 @ x) sama dengan (W2 @ W1) @ x. Uji kami memastikannya. Setebal apa pun tumpukannya, tanpa aktivasi jaringan tetap tak bisa mempelajari XOR.
Catatan
Teorema aproksimasi universal (Hornik dkk. dan Cybenko, 1989) menyatakan bahwa jaringan dengan satu lapisan tersembunyi yang cukup lebar bisa mendekati fungsi kontinu apa pun pada daerah yang terbatas. Tetapi Goodfellow dkk. mengingatkan: teorema itu tak menjamin pelatihan berhasil menemukan bobotnya.
3
Loss: angka yang mengukur seberapa salah
Supaya bisa belajar, jaringan perlu tahu seberapa jauh tebakannya meleset. Ukuran itu disebut loss: satu angka yang makin kecil makin baik.
Untuk tugas memilih kelas, lapisan terakhir mengeluarkan satu skor mentah per kelas, yang disebut logit. Fungsi softmax mengubah logit menjadi peluang yang berjumlah 1. Lalu cross-entropy menghitung loss dari peluang jawaban yang benar:
python
def softmax(logit: Larik) -> Larik:
    e: Larik = np.exp(logit - logit.max())  # dikurangi nilai terbesar supaya exp tak meluap
    return e / e.sum()


def cross_entropy(logit: Larik, benar: int) -> float:
    return float(-np.log(softmax(logit)[benar]))  # kecil bila peluang jawaban benar besar
Coba dengan logit 2; 0,5; dan −1. Softmax memberi peluang 0,79, 0,18, dan 0,04. Bila jawaban benar adalah kelas pertama, loss-nya hanya 0,24. Bila jawaban benar ternyata kelas ketiga, yang dianggap paling tak mungkin, loss-nya melonjak ke 3,24. Cross-entropy menghukum tebakan yang yakin tetapi salah dengan sangat berat.
Satu angka layak diingat: bila model menebak rata untuk 3 kelas, loss-nya ln 3 ≈ 1,0986. Model yang baru dibuat seharusnya mulai dari sekitar angka ini. Langkah 12 memakainya untuk memeriksa model.
Peringatan
nn.CrossEntropyLoss di PyTorch menerima logit mentah, bukan peluang. Dokumentasinya menyebut fungsi ini setara dengan LogSoftmax diikuti NLLLoss. Jangan menerapkan softmax sendiri sebelum memanggilnya. Uji kami memastikan fungsi cross_entropy di atas memberi angka yang sama dengan nn.CrossEntropyLoss pada logit mentah.
Untuk menebak angka, misalnya harga, loss yang lazim adalah mean squared error: rata-rata kuadrat selisih tebakan dan jawaban.
4
Gradient descent: menuruni bukit dalam kabut
Bayangkan kamu berdiri di lereng bukit berkabut tebal dan ingin turun ke lembah. Kamu tak bisa melihat lembahnya. Yang bisa kamu rasakan hanya kemiringan tanah di bawah kaki. Strategi terbaik: melangkah ke arah yang paling menurun, lalu ulangi.
Itulah gradient descent. Bukitnya adalah loss, dan posisimu adalah nilai bobot. Gradien adalah turunan loss terhadap setiap bobot, dan menunjuk ke arah naik paling curam. Jadi kita melangkah ke arah sebaliknya. Panjang langkahnya disebut laju belajar (learning rate, sering disingkat lr).
python
def turuni(lr: float, langkah: int = 20, w: float = 0.0) -> list[float]:
    """Kembalikan posisi w di setiap langkah, mulai dari posisi awal."""
    jejak = [w]
    for _ in range(langkah):
        grad = 2 * (w - 3)  # turunan loss (w - 3)^2 terhadap w
        w = w - lr * grad  # melangkah berlawanan arah gradien
        jejak.append(w)
    return jejak
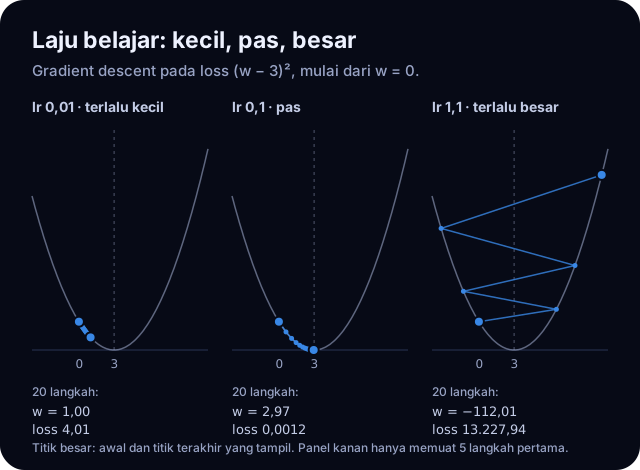
Lembah loss (w − 3)² ada di w = 3. Mulai dari w = 0, inilah hasil 20 langkah dengan tiga laju belajar:
Jejak w dihitung oleh fungsi turuni di atas.Lisensi: Karya sendiri
Laju belajar
Sesudah 20 langkah
Loss
0,01
w = 1,00, masih jauh
4,01
0,1
w = 2,96, hampir tiba
0,0012
1,1
melompati lembah makin jauh
13.227,94
Laju yang terlalu kecil membuat latihan sangat lambat. Laju yang terlalu besar membuat bobot melompat-lompat dan meledak. Memilih laju belajar adalah salah satu keputusan terpenting saat melatih jaringan.
Jaringan sungguhan punya sangat banyak bobot, jadi bukitnya berdimensi sangat banyak. Tetapi prinsipnya sama: hitung gradien untuk setiap bobot, lalu melangkah sedikit berlawanan arah. Pertanyaannya tinggal satu: bagaimana menghitung semua gradien itu dengan cepat? Jawabannya ada di langkah berikutnya.
5
Rambat balik: menelusuri kesalahan ke belakang
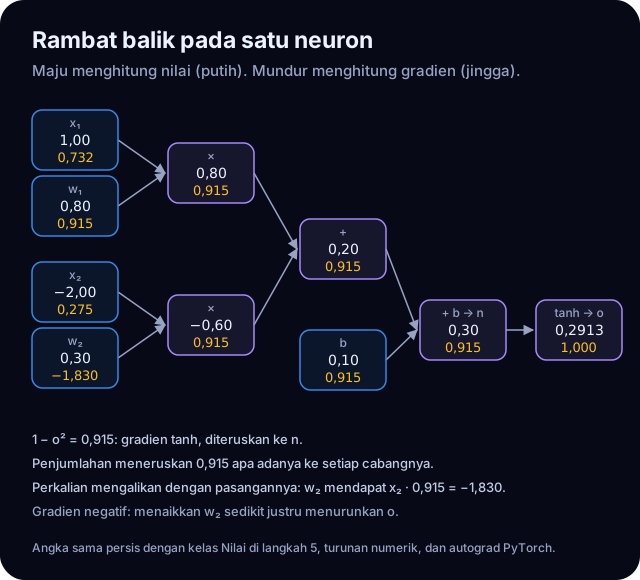
Jaringan adalah rangkaian operasi kecil: kali, tambah, aktivasi. Rambat balik menghitung gradien setiap bobot dengan menelusuri rangkaian itu dari belakang, memakai aturan rantai kalkulus. Bila o bergantung pada n, dan n bergantung pada w, maka pengaruh w terhadap o adalah perkalian kedua pengaruh itu.
Cara termudah memahaminya adalah membangun versi mini sendiri. Kelas Nilai di bawah, terinspirasi pustaka micrograd karya Andrej Karpathy, menyimpan sebuah angka beserta asal-usulnya. Setiap operasi tahu cara meneruskan gradien ke belakang:
Penjumlahan meneruskan gradien apa adanya. Perkalian mengalikannya dengan angka pasangannya. Metode mundur() lalu memanggil langkah-langkah itu dalam urutan terbalik, dari hasil akhir ke masukan.
Angka dari kelas Nilai, sama dengan turunan numerik dan autograd PyTorch.Lisensi: Karya sendiri
Untuk neuron o = tanh(x1·w1 + x2·w2 + b), gradien w2 adalah −1,830. Artinya, menaikkan w2 sedikit justru menurunkan o. Uji kami mencocokkan setiap gradien dengan dua pembanding: turunan numerik (menggeser angka sedikit lalu mengukur perubahannya) dan autograd PyTorch. Ketiganya sama.
Perhatikan tanda +=. Bila sebuah angka dipakai dua kali, misalnya a * a, gradiennya dijumlahkan: untuk a = 3, hasilnya 2a = 6. Memakai = akan menghapus salah satu sumbangan, sebuah bug klasik.
Tonton di YouTubeApa yang sebenarnya terjadi pada jaringan saat belajar, dijelaskan secara intuitif sebelum masuk ke kalkulusnya (13 menit, November 2017).Sumber: 3Blue1Brown di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
Goodfellow dkk. mengingatkan satu salah kaprah: rambat balik bukan seluruh algoritme belajar. Ia hanya cara menghitung gradien. Gradient descent yang memakainya untuk memperbarui bobot.
6
Melatih jaringan pertamamu dengan NumPy
Sekarang semua bahan sudah ada. Kita melatih jaringan dua lapis untuk XOR, kali ini mulai dari bobot acak, tanpa bantuan buku. Fungsi di bawah melakukan satu putaran penuh: maju menghitung tebakan dan loss, lalu mundur menghitung gradien setiap bobot dengan aturan rantai, ditulis tangan.
python
def maju_mundur(P: dict[str, Larik]) -> tuple[float, Larik, dict[str, Larik]]:
    # maju: hitung tebakan dan loss
    z1 = X @ P["W1"] + P["b1"]
    h = np.maximum(0, z1)  # ReLU
    z2 = h @ P["W2"] + P["b2"]
    p = 1 / (1 + np.exp(-z2))  # sigmoid: peluang jawabannya 1
    loss = -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p))
    # mundur: aturan rantai, dari loss ke setiap bobot
    dz2 = (p - y) / len(X)
    dh = dz2 @ P["W2"].T
    dz1 = dh * (z1 > 0)  # ReLU meneruskan gradien hanya bila z1 > 0
    G = {"W2": h.T @ dz2, "b2": dz2.sum(0), "W1": X.T @ dz1, "b1": dz1.sum(0)}
    return float(loss), p, G
Fungsi latih cukup memanggil fungsi ini berulang-ulang dan menggeser setiap bobot sedikit berlawanan arah gradiennya. Hasil 2.000 langkah dengan laju belajar 0,5:
loss turun dari 0,711 ke 0,0006;
tebakan untuk keempat titik menjadi 0,001; 0,999; 1,000; 0,000, yaitu 0, 1, 1, 0 bila dibulatkan;
dari 20 benih acak yang berbeda, 20 berhasil.
Gradien tulisan tangan mudah salah, jadi uji kami memeriksanya dengan turunan numerik. Ada cerita kecil di sini: pemeriksaan pertama kami gagal untuk bias b1. Penyebabnya, bias awal 0 membuat masukan (0, 0) jatuh tepat di titik tekuk ReLU, tempat turunan numerik dan turunan ReLU tidak sepakat. Dengan bias awal yang sedikit bergeser, semua gradien cocok. Pemeriksaan gradien sebaiknya dilakukan di titik yang jauh dari tekukan seperti itu.
Tonton di YouTubeAndrej Karpathy membangun autograd mini dan melatih jaringan kecil dari nol, langkah demi langkah (hampir 2,5 jam, Agustus 2022).Sumber: Andrej Karpathy di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
Kalau ingin melihat seluruh proses ini dibangun dari nol sambil dijelaskan, video Andrej Karpathy di atas adalah teman yang sangat baik.
7
PyTorch: biarkan autograd yang menghitung
Untuk bekerja sungguhan, kita memakai pustaka seperti PyTorch. Mesin torch.autograd-nya merekam setiap operasi pada tensor dan menghitung gradien secara otomatis, persis seperti kelas Nilai, tetapi untuk tensor besar dan bisa berjalan di GPU.
Inilah inti putaran latihan untuk data spiral tiga kelas, yang tak bisa dipisahkan garis lurus:
python
    loss_fn = nn.CrossEntropyLoss()  # menerima logit mentah, bukan peluang
    opt = torch.optim.AdamW(model.parameters(), lr=lr)
    riwayat = []
    for _ in range(epoch):
        model.train()
        for xb, yb in loader:
            loss = loss_fn(model(xb), yb)
            opt.zero_grad()  # gradien menumpuk bila tidak dinolkan
            loss.backward()  # rambat balik: isi .grad setiap parameter
            opt.step()  # perbarui bobot memakai gradien itu
        model.eval()
        with torch.no_grad():
            loss_val = loss_fn(model(X_val), y_val).item()
Tutorial resmi PyTorch menyebut tiga langkah optimasi di dalam putaran: zero_grad(), backward(), dan step(). Langkah pertama sering terlupa. Gradien di PyTorch menumpuk secara bawaan, jadi tanpa zero_grad() gradien putaran sebelumnya ikut terbawa. Uji kami: memanggil backward() dua kali menghasilkan gradien dua kali lipat.
Dua hal lain dari kode di atas:
model.train() dan model.eval() mengubah perilaku lapisan seperti dropout (langkah 9). Penilaian dibungkus torch.no_grad() supaya PyTorch tak merekam operasi yang tak perlu.
AdamW adalah optimizer yang melangkah lebih cerdas daripada gradient descent biasa (langkah 10). Bawaannya laju belajar 0,001 dan weight decay 0,01.
Hasilnya, dengan 600 contoh latih dan 300 contoh validasi:
Model
Akurasi validasi
jaringan 2 lapisan tersembunyi, masing-masing 64 neuron
99,7%
model linear, tanpa lapisan tersembunyi
48,0%
Model linear hanya bisa menarik garis lurus. Jaringan berlapis menemukan lengkungan spiralnya.
8
Data: latih, validasi, dan uji
Pustakawan baru kita akan tampak hebat bila diuji dengan buku-buku yang sama yang dipakai seniornya untuk melatihnya. Ia mungkin cuma hafal. Ujian yang jujur memakai buku yang belum pernah ia lihat. Karena itu data dibagi menjadi tiga:
Bagian
Dipakai untuk
Aturan
latih
menyetel bobot
satu-satunya data yang dilihat optimizer
validasi
memilih laju belajar, ukuran model, kapan berhenti
dilihat berkali-kali, jadi lama-lama ikut "terhafal" lewat pilihanmu
uji
menilai model akhir
dibuka sekali di akhir, sesudah semua keputusan diambil
Bila kamu terus menyetel model sambil melirik data uji, angka ujinya tak lagi jujur. Masalah ini disebut kebocoran data, dan mudah terjadi tanpa disadari.
Optimizer juga jarang menghitung gradien dari seluruh data sekaligus. Data dipotong menjadi minibatch, misalnya 32 contoh, dan bobot diperbarui sekali per minibatch. Satu putaran melewati seluruh data latih disebut epoch.
Dengan 600 contoh dan minibatch 32, satu epoch berisi 19 langkah pembaruan. shuffle=True mengacak urutan setiap epoch, supaya minibatch tak selalu berisi contoh yang sama. Gradien dari minibatch hanya perkiraan gradien sebenarnya. Itulah sebabnya metode ini disebut stochastic gradient descent. Perkiraan yang sedikit berderau itu ternyata cukup, dan jauh lebih hemat memori.
Satu prinsip lagi: model hanya bisa mempelajari pola yang ada di data latihnya. Bila data uji, atau dunia nyata, berbeda jauh dari data latih, akurasi validasi yang tinggi tak menjamin apa-apa.
9
Overfitting: ketika model menghafal
Bila pustakawan kita hanya pernah melihat 60 buku, ia bisa menghafal setiap buku, termasuk noda kopi yang kebetulan ada di buku-buku rusak, lalu menyimpulkan bahwa noda kopi berarti rusak. Di buku baru, hafalan itu menyesatkan. Inilah overfitting.
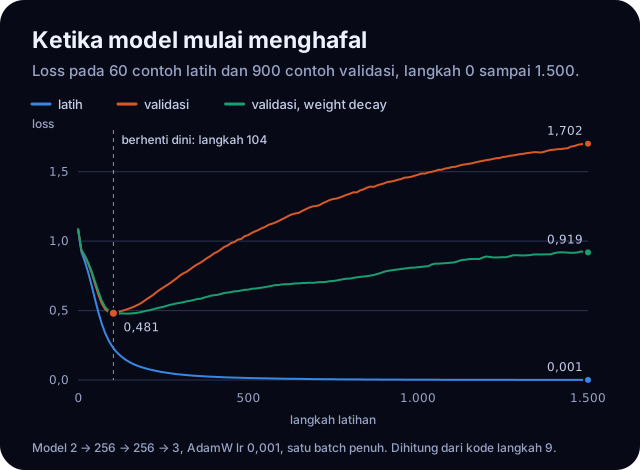
Uji kami melatih jaringan besar (dua lapisan tersembunyi, masing-masing 256 neuron) pada hanya 60 contoh spiral berderau, lalu mencatat loss pada 900 contoh validasi:
Dihitung dari percobaan di langkah ini: 60 contoh latih, 900 contoh validasi.Lisensi: Karya sendiri
Loss latih terus turun sampai 0,001. Loss validasi turun ke titik terendah 0,481 di langkah 104, lalu naik terus sampai 1,702. Akurasi validasinya hampir tak berubah (82,7% di langkah 104, 83,9% di akhir). Yang memburuk keyakinannya: model makin yakin pada tebakan yang salah, dan cross-entropy menghukumnya.
Tiga penawar yang kami ukur:
Berhenti dini: simpan model di titik loss validasi terendah.
Weight decay (koefisien 1,0): menyusutkan bobot sedikit di setiap langkah. Loss validasi akhir 0,919.
Dropout (p = 0,5): mematikan neuron secara acak selama latihan. Loss validasi akhir 0,992.
python
def berhenti_dini(riwayat: list[tuple[float, float]], sabar: int = 100) -> int:
    """Langkah terbaik menurut loss validasi; berhenti bila tak membaik selama `sabar` langkah."""
    terbaik, langkah_terbaik = float("inf"), 0
    for i, (_, val) in enumerate(riwayat):
        if val < terbaik:
            terbaik, langkah_terbaik = val, i
        elif i - langkah_terbaik >= sabar:
            break
    return langkah_terbaik
Menurut dokumentasi PyTorch, dropout mengalikan keluaran yang tersisa dengan 1/(1−p) saat latihan dan tak berbuat apa-apa saat evaluasi, jadi panggil model.eval() sebelum menilai.
Zhang dkk. (2016) bahkan menemukan jaringan konvolusi bisa mencapai galat latih nol pada label yang diacak. Versi kecil kami: dengan label acak, 10 dari 10 percobaan mencapai akurasi latih 100%, sedangkan akurasi validasinya rata-rata 30,3%, setara menebak asal untuk 3 kelas.
10
Membuat jaringan yang sangat dalam bisa dilatih
Kalau berlapis itu bagus, kenapa tidak menumpuk 30 lapisan? Masalahnya, gradien dikalikan berulang kali saat mengalir mundur. Bila setiap perkalian mengecilkannya sedikit, gradien di lapisan awal nyaris hilang. Uji kami mengukur besar gradien di lapisan pertama dan terakhir:
Tumpukan 30 lapisan
Lapisan pertama
Lapisan terakhir
sigmoid, inisialisasi bawaan
0 (di bawah batas float32)
0,13
ReLU, inisialisasi bawaan
4,0 × 10⁻¹⁴
0,0065
ReLU, inisialisasi He
0,036
0,081
blok residual + LayerNorm
2,0
1,6
Empat penemuan yang menolong:
Aktivasi dan inisialisasi. Glorot dan Bengio (2010) menunjukkan sigmoid tak cocok untuk jaringan dalam berbobot acak karena mudah jenuh. He dkk. (2015) menurunkan inisialisasi khusus ReLU, tersedia di PyTorch sebagai nn.init.kaiming_normal_.
Normalisasi.Batch normalization (2015) menormalkan masukan setiap lapisan per minibatch. Layer normalization (2016) menormalkan per contoh, jadi perhitungannya sama saat latihan dan uji. Transformer memakainya.
Sambungan residual. He dkk. (2015) menemukan jaringan biasa yang lebih dalam justru punya galat latih lebih tinggi, padahal ini bukan overfitting. Solusinya: tambahkan masukan setiap blok ke keluarannya. Gabungan jaringan residual hingga 152 lapisan menjuarai ILSVRC 2015.
Optimizer adaptif. Adam (Kingma dan Ba, 2014) menyetel panjang langkah setiap parameter, dengan nilai bawaan makalah yang sama dengan bawaan PyTorch. AdamW memisahkan weight decay dari langkah itu.
python
class BlokResidual(nn.Module):
    def __init__(self, lebar: int) -> None:
        super().__init__()
        self.norm = nn.LayerNorm(lebar)
        self.linear = nn.Linear(lebar, lebar)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        perubahan: torch.Tensor = self.linear(torch.relu(self.norm(x)))
        return x + perubahan  # jalan pintas: masukan ditambahkan kembali
11
Arsitektur: bentuk jaringan mengikuti bentuk data
Semua jaringan di halaman ini sejauh ini adalah multilayer perceptron (MLP): setiap neuron tersambung ke semua neuron di lapisan sebelumnya. Untuk data tertentu, ada bentuk yang jauh lebih cocok. LeCun, Bengio, dan Hinton (2015) merangkumnya: jaringan konvolusi membawa terobosan untuk gambar, video, suara, dan audio, sedangkan jaringan rekuren menerangi data berurutan seperti teks dan ucapan.
Arsitektur
Cocok untuk
Gagasan kuncinya
MLP
data tabel, fitur dengan panjang tetap
semua tersambung ke semua
Konvolusi (CNN)
gambar, suara
filter kecil yang sama digeser ke seluruh masukan
Rekuren (RNN, LSTM)
urutan
membaca satu per satu sambil membawa ingatan
Transformer
teks, dan dasar setiap LLM
atensi: setiap posisi melihat posisi lain
Kenapa konvolusi cocok untuk gambar? Bandingkan jumlah parameternya untuk gambar 28×28 piksel:
python
def bandingkan() -> tuple[int, int]:
    penuh = nn.Linear(28 * 28, 32)  # setiap piksel punya bobot sendiri ke setiap fitur
    konv = nn.Conv2d(1, 32, kernel_size=3)  # 32 filter 3x3 yang digeser ke seluruh gambar
    return jumlah_parameter(penuh), jumlah_parameter(konv)
Lapisan penuh butuh 25.120 parameter. Konvolusi hanya 320, karena filter 3×3 yang sama dipakai di semua posisi. Bonusnya, bila objek dalam gambar bergeser dua piksel, peta fitur konvolusi ikut bergeser dua piksel. Uji kami memastikannya. Kucing di pojok kiri dan kucing di pojok kanan dikenali dengan filter yang sama.
Transformer dibahas mendalam di topik Large Language Model, sedangkan konvolusi dan pemrosesan teks adalah inti bidang Computer Vision dan NLP.
12
Resep latihan dan batas deep learning
Andrej Karpathy, dalam tulisannya A Recipe for Training Neural Networks (2019), memperingatkan bahwa latihan jaringan saraf gagal secara diam-diam. Kode yang salah sering tetap berjalan tanpa pesan galat, hanya hasilnya sedikit lebih buruk. Karena itu ia menyarankan kebiasaan memeriksa yang ketat, dan beberapa di antaranya sudah kamu praktikkan di halaman ini:
Kunci benih acak, supaya dua kali menjalankan kode memberi hasil yang sama.
Periksa loss saat mulai. Untuk softmax dengan C kelas, loss awal semestinya sekitar −ln(1/C). Model spiral kita mulai dari 1,084, dekat ln 3 = 1,0986.
Buat model menghafal satu batch kecil dulu. Bila tak bisa mencapai loss mendekati nol pada beberapa contoh saja, ada yang salah di kode, bukan di data.
Mulai dengan Adam. Karpathy menyebut Adam dengan laju belajar 3e-4 sebagai pilihan awal yang aman, karena lebih pemaaf terhadap pengaturan yang kurang pas.
Lihat datanya dengan mata sendiri sebelum menyentuh model.
Deep learning juga punya batas yang perlu kamu kenali:
Lapar data. Jaringan besar butuh banyak contoh. Dengan 60 contoh, jaringan kita lebih memilih menghafal (langkah 9).
Sulit dijelaskan. Pengetahuan model tersebar di banyak sekali bobot. Ia tak bisa menunjuk aturan yang dipakainya.
Hanya sebaik datanya. Pola yang tak ada di data latih tak bisa dipelajari, dan bias di data ikut terbawa ke model.
Butuh daya hitung. Contoh di halaman ini berjalan di CPU dalam hitungan detik, tetapi model besar dilatih dengan GPU atau akselerator lain. Di PyTorch, model.to("cuda") memindahkan model ke GPU bila tersedia.
Dengan fondasi ini, kamu siap memahami bagaimana jaringan yang sama, dalam ukuran raksasa, menjadi Large Language Model.
Pustaka deep learning sumber terbuka untuk Python: tensor yang bisa berjalan di GPU, autograd yang menghitung gradien secara otomatis, serta modul lapisan, fungsi loss, dan optimizer.
Dipakai mulai langkah 7 untuk putaran latihan, dan di langkah 9 sampai 11 untuk overfitting, jaringan dalam, dan konvolusi. Contoh diuji dengan versi 2.14.1 di CPU.
04
Mini Project
Misi
Pengenal angka tulisan tangan, dari NumPy ke PyTorch
Bangun pengenal angka tulisan tangan untuk data MNIST: gambar 28×28 piksel berisi angka 0 sampai 9. Data ini bisa diunduh lewat torchvision.datasets.MNIST.
Tulis dulu versi NumPy dengan rambat balik tulisan tangan, seperti langkah 6.
Lalu tulis ulang dengan PyTorch, sekali sebagai MLP dan sekali sebagai jaringan konvolusi kecil.
Sisihkan data validasi dari data latih. Data uji resmi MNIST baru dibuka di akhir.
Kamu selesai bila:
pemeriksaan gradienmu membuktikan rambat balik NumPy cocok dengan turunan numerik, di titik yang jauh dari tekukan ReLU;
loss awalmu dicatat dan dibandingkan dengan ln 10;
kamu menyimpan grafik loss latih dan validasi untuk ketiga model, dan menandai titik berhenti dini;
tabelmu membandingkan jumlah parameter dan akurasi uji ketiga model;
kamu menampilkan 10 gambar yang salah ditebak oleh model terbaik dan menjelaskan pola kesalahannya.
Misi
Detektif overfitting
Proyek kedua melatih mata untuk membaca kurva. Pakai data spiral dari langkah 7, atau data kecil milikmu sendiri.
Sengaja buat model yang overfitting: data latih sedikit, model besar, latihan lama.
Terapkan penawar satu per satu: berhenti dini, weight decay, dropout, dan menambah data latih.
Ulangi percobaan label acak dari langkah 9.
Kamu selesai bila:
grafikmu memperlihatkan loss latih yang terus turun sementara loss validasi naik;
setiap penawar diukur dengan benih yang sama, dan hasilnya ditulis dalam satu tabel: loss validasi terendah, loss validasi akhir, dan akurasi validasi;
kamu menjalankan setiap konfigurasi dengan setidaknya 3 benih acak dan melaporkan rata-ratanya, karena satu percobaan bisa kebetulan;
percobaan label acakmu mencatat akurasi latih dan validasi, lalu kamu menjelaskan apa artinya;
tulisan singkatmu menyimpulkan penawar mana yang paling membantu untuk datamu, dan kenapa.