Computer vision mengajari komputer memahami gambar dan video: mengenali benda, menemukan letaknya, dan memisahkan setiap piksel menurut artinya. Bagi komputer, gambar hanyalah tabel angka, dan jaringan konvolusi (CNN) belajar menemukan pola di dalamnya: mula-mula tepi dan sudut, lalu bentuk, lalu benda utuh. Di halaman ini kamu belajar lewat cerita perpustakaan yang memasang kamera di troli pengembalian untuk mengenali stiker di punggung buku. Kamu menulis konvolusi dengan tangan, membangun dan melatih CNN pertamamu, melihat sendiri kenapa model bisa gagal ketika gambar sedikit bergeser, lalu memperbaikinya dengan augmentasi. Sesudah itu kamu mengenal arsitektur penting dari AlexNet sampai Vision Transformer, transfer learning dengan torchvision, deteksi objek dengan IoU dan non-maximum suppression, cara mengirim gambar ke Claude beserta hitungan biayanya, dan batas-batas computer vision seperti contoh adversarial. Semua contoh kode sudah dijalankan di CPU laptop biasa, tanpa GPU dan tanpa biaya.
Kamera di troli pengembalian
Perpustakaan kita sedang sibuk. Setiap hari ratusan buku dikembalikan, dan setiap buku harus kembali ke raknya. Untung setiap punggung buku sudah ditempeli stiker bentuk: lingkaran untuk fiksi, persegi untuk sains, dan segitiga untuk sejarah. Kepala perpustakaan lalu punya ide: pasang kamera kecil di troli pengembalian, biarkan komputer melihat stikernya, lalu tunjukkan rak tujuannya.
Kedengarannya mudah, karena manusia mengenali bentuk tanpa berpikir. Tetapi bagi komputer, foto stiker hanyalah tabel angka kecerahan. Ia harus belajar sendiri bahwa sekumpulan angka tertentu berarti "lingkaran", di mana pun stiker itu menempel dan seburam apa pun fotonya. Itulah pekerjaan computer vision.
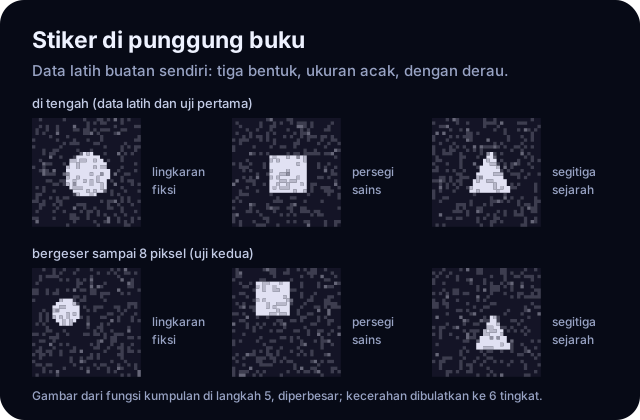
Gambar dari kode di langkah 5, diperbesar; kecerahan dibulatkan ke 6 tingkat.Lisensi: Karya sendiri
Peta perjalanan
Bagian
Pertanyaan yang dijawab
Langkah
Bahan dasar
bagaimana gambar disimpan, dan apa itu konvolusi
1–3
CNN pertama
membangun, melatih, dan menguji di luar kebiasaan
4–6
Berdiri di pundak raksasa
arsitektur terkenal dan transfer learning
7–8
Lebih dari sekadar label
deteksi objek, segmentasi, dan Vision Transformer
9–10
Praktik dan batas
mengirim gambar ke Claude, dan cara model bisa dikelabui
11–12
Hubungannya dengan topik lain
Halaman ini memakai bahan dari topik Deep Learning: neuron, loss, rambat balik, dan putaran latihan PyTorch. Bila istilah-istilah itu belum akrab, mulailah dari sana. Di langkah 10 kamu juga akan melihat bahwa Vision Transformer memakai atensi yang sama dengan Large Language Model.
Catatan
Data stiker di halaman ini dibuat sendiri dengan kode, sehingga siapa pun bisa mengulang percobaannya tanpa mengunduh apa-apa. Angka-angkanya berasal dari kode yang dijalankan dengan PyTorch 2.14.1 dan torchvision 0.29.1 di CPU.
02
Learning Roadmap
Prasyarat
Yang perlu kamu kenal dulu: PyTorch dan dasar deep learning
Sebelum mulai, pastikan hal-hal ini sudah akrab bagimu:
Dasar deep learning: neuron, loss, gradient descent, dan putaran latihan zero_grad(), backward(), step(). Semuanya dibahas di topik Deep Learning.
Python dan PyTorch: membuat tensor, mengubah bentuknya dengan reshape, dan memanggil nn.Sequential.
Data latih, validasi, dan uji, serta gagasan overfitting.
Pasang pustakanya dengan pip install torch torchvision. Semua contoh berjalan di CPU dalam hitungan detik sampai satu menit, dan tak ada yang memanggil API berbayar.
1
Gambar di mata komputer: tabel angka
Bagi komputer, foto hitam-putih adalah tabel angka kecerahan, satu angka per piksel. Foto berwarna punya tiga tabel seperti itu, masing-masing untuk merah, hijau, dan biru. Tabel-tabel ini disebut kanal. PyTorch menyimpan gambar sebagai tensor berbentuk (kanal, tinggi, lebar).
Begini cara kita membuat foto stiker untuk percobaan, langsung dari rumus bentuknya:
python
def stiker(kelas: int, cx: float = 16.0, cy: float = 16.0, r: float = 6.0, ukuran: int = 32) -> torch.Tensor:
    """Gambar abu-abu 1 x 32 x 32: stiker terang (1,0) di atas punggung buku gelap (0,0)."""
    y, x = torch.meshgrid(torch.arange(ukuran, dtype=torch.float32),
                          torch.arange(ukuran, dtype=torch.float32), indexing="ij")
    if kelas == 0:
        isi = (x - cx) ** 2 + (y - cy) ** 2 <= r ** 2
    elif kelas == 1:
        isi = ((x - cx).abs() <= 0.85 * r) & ((y - cy).abs() <= 0.85 * r)
    else:  # segitiga, puncaknya di atas
        isi = (y >= cy - r) & (y <= cy + r) & ((x - cx).abs() <= (y - (cy - r)) / 2)
    return isi.float().unsqueeze(0)  # tambahkan sumbu kanal: (1, 32, 32)
Hasilnya tensor (1, 32, 32): satu kanal, 32 × 32 = 1,024 piksel, dengan nilai 0 untuk punggung buku yang gelap dan 1 untuk stiker yang terang.
Dua kebiasaan yang perlu kamu tahu saat memakai foto sungguhan:
Berkas gambar biasanya menyimpan setiap piksel sebagai bilangan bulat 0 sampai 255. v2.ToDtype(torch.float32, scale=True) dari torchvision mengubahnya menjadi 0 sampai 1. Uji kami: 0, 128, dan 255 menjadi 0; 0,502; dan 1.
Mengubah foto berwarna menjadi abu-abu bukan sekadar rata-rata ketiga kanal. Fungsi rgb_to_grayscale di torchvision memberi bobot 0,2989 untuk merah, 0,587 untuk hijau, dan 0,114 untuk biru. Uji kami memastikan piksel merah murni menjadi 0,2989.
Karena bentuk tensornya penting, biasakan mencetak .shape setiap kali ragu. Banyak galat dalam computer vision ternyata hanya kanal yang tertukar tempat.
2
Konvolusi: kaca pembesar yang digeser
Bayangkan kamu memeriksa poster dengan kaca pembesar kecil. Kamu menggesernya sedikit demi sedikit, dan di setiap posisi kamu hanya bertanya satu hal, misalnya "apakah di sini ada batas gelap dan terang?". Itulah konvolusi. Kaca pembesarnya disebut filter atau kernel: tabel bobot kecil, misalnya 3 × 3.
python
def konvolusi(gambar: Larik, filter_: Larik) -> Larik:
    """Geser filter ke setiap posisi; di tiap posisi, kalikan lalu jumlahkan."""
    tf, lf = filter_.shape
    tinggi, lebar = gambar.shape[0] - tf + 1, gambar.shape[1] - lf + 1
    hasil = np.zeros((tinggi, lebar))
    for i in range(tinggi):
        for j in range(lebar):
            hasil[i, j] = np.sum(gambar[i:i + tf, j:j + lf] * filter_)
    return hasil
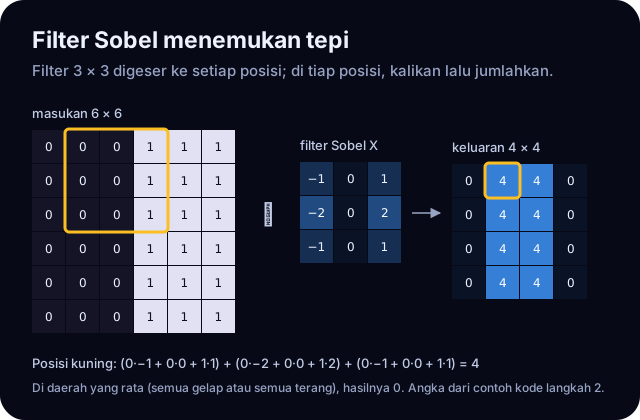
Filter Sobel di bawah peka terhadap tepi tegak. Pada gambar yang separuh kirinya gelap dan separuh kanannya terang, setiap baris keluarannya bernilai 0, 4, 4, 0. Angka besar hanya muncul tepat di perbatasan:
Angka dari fungsi konvolusi di atas.Lisensi: Karya sendiri
Satu fakta kecil yang sering membingungkan: dokumentasi PyTorch menyebut nn.Conv2d sebagai operasi cross-correlation, bukan konvolusi dalam arti matematika yang membalik filternya lebih dulu. Uji kami: fungsi di atas memberi angka yang sama persis dengan F.conv2d, sedangkan filter Sobel yang dibalik memberi tanda kebalikannya. Dalam CNN perbedaan ini tak penting, karena bobot filternya dipelajari, bukan ditulis tangan.
Inilah kekuatan CNN: ia tak diberi filter Sobel, melainkan menemukan sendiri filter yang berguna. Yosinski dkk. (2014) mencatat bahwa lapisan pertama jaringan yang dilatih pada foto alami cenderung mempelajari filter mirip detektor tepi dan gumpalan warna, dan fitur seumum itu berguna untuk banyak tugas lain.
Tonton di YouTubeKonvolusi dijelaskan dengan animasi, dari peluang sampai pengolahan gambar seperti memburamkan dan mendeteksi tepi (23 menit, November 2022).Sumber: 3Blue1Brown di YouTube · Lisensi: Lisensi standar YouTube; disematkan lewat pemutar YouTube
3
Padding, stride, dan pooling
Tiga pengaturan menentukan ukuran keluaran sebuah konvolusi:
Ukuran filter (F): seberapa luas yang dilihat sekali geser.
Padding (P): bingkai nol yang ditambahkan di tepi, supaya piksel pinggir ikut terlihat dan ukuran tak menyusut.
Stride (S): sejauh apa filter melompat setiap kali digeser.
Catatan kuliah CS231n dari Stanford merangkumnya dalam satu rumus untuk masukan selebar W:
python
def ukuran_keluaran(W: int, F: int, P: int = 0, S: int = 1) -> int:
    """Lebar keluaran untuk masukan selebar W, filter F, padding P, dan stride S."""
    return (W - F + 2 * P) // S + 1
Contoh dari catatan itu: masukan 7 × 7 dengan filter 3 × 3 menghasilkan 5 × 5. Dengan stride 2, hasilnya 3 × 3. Uji kami mencocokkan rumus ini dengan nn.Conv2d pada tujuh kombinasi, termasuk lapisan pertama AlexNet: gambar 227 piksel, filter 11, stride 4, menjadi 55.
Pooling mengecilkan peta fitur dengan meringkas setiap petak kecil. Max pooling 2 × 2 mengambil angka terbesar di setiap petak 2 × 2, sehingga 32 × 32 menjadi 16 × 16. Hasilnya, lapisan berikutnya "melihat" daerah yang lebih luas dengan perhitungan yang lebih sedikit.
Kenapa konvolusi hemat? Karena satu filter dipakai bersama di semua posisi. Catatan CS231n menghitung lapisan pertama AlexNet: 55 × 55 × 96 = 290.400 neuron, masing-masing dengan 363 bobot dan 1 bias. Bila setiap neuron punya bobotnya sendiri, lapisan itu saja butuh 105.705.600 parameter. Dengan berbagi bobot, cukup 96 filter, masing-masing 364 parameter: total 34.944.
4
Membangun CNN pertamamu
Sekarang kita susun CNN untuk mengenali stiker. Polanya klasik: konvolusi, ReLU, pooling, diulang dua kali, lalu satu lapisan linear yang memberi skor untuk ketiga kelas.
python
def cnn() -> nn.Sequential:
    return nn.Sequential(
        nn.Conv2d(1, 8, kernel_size=3, padding=1), nn.ReLU(), nn.MaxPool2d(2),  # 8 x 16 x 16
        nn.Conv2d(8, 16, kernel_size=3, padding=1), nn.ReLU(), nn.MaxPool2d(2),  # 16 x 8 x 8
        nn.Flatten(), nn.Linear(16 * 8 * 8, 3),  # satu skor per kelas
    )
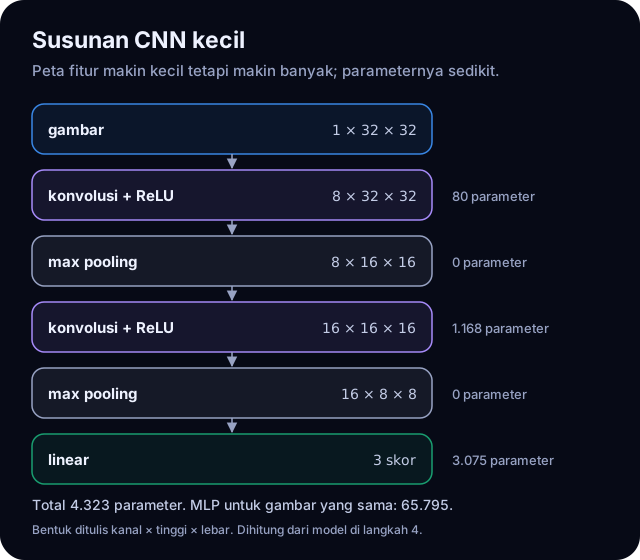
Bentuk dan jumlah parameter dihitung dari model di atas.Lisensi: Karya sendiri
Perhatikan dua hal:
Peta fitur makin kecil tetapi makin banyak. Dari 1 × 32 × 32 menjadi 8 × 16 × 16, lalu 16 × 8 × 8. Lapisan awal melihat potongan kecil seperti tepi. Lapisan sesudahnya menggabungkan tepi-tepi itu menjadi pola yang lebih besar, seperti lengkungan atau sudut.
Parameternya sedikit. Seluruh CNN ini hanya berisi 4.323 parameter. Sebagai pembanding, MLP sederhana yang menyambungkan setiap piksel ke 64 neuron butuh 65.795 parameter, lima belas kali lebih banyak.
Bentuk tensor di setiap tahap mudah salah hitung. Uji kami menjalankan gambar kosong melewati model dan mencatat bentuk sesudah setiap pooling, persis 8 × 16 × 16 dan 16 × 8 × 8. Kebiasaan ini layak kamu tiru: buat tensor nol berbentuk benar, lewatkan ke model, lalu cetak bentuk keluarannya sebelum mulai melatih.
Kita buat 900 foto stiker untuk latihan, 300 per bentuk, dengan ukuran acak dan derau seperti hasil pindaian. Semuanya kira-kira di tengah, karena di troli percobaan buku selalu diletakkan rapi.
python
def kumpulan(n: int, benih: int, geser: float, derau: float = 0.15) -> tuple[torch.Tensor, torch.Tensor]:
    """n gambar per kelas, ukuran acak; `geser` = pergeseran acak terjauh dari tengah, dalam piksel."""
    g = torch.Generator().manual_seed(benih)
    X, y = [], []
    for k in range(len(KELAS)):
        for _ in range(n):
            r = 4 + 4 * torch.rand(1, generator=g).item()
            dx, dy = ((torch.rand(2, generator=g) * 2 - 1) * geser).tolist()
            gambar = stiker(k, cx=16 + dx, cy=16 + dy, r=r)
            X.append(gambar + derau * torch.randn(gambar.shape, generator=g))
            y.append(k)
    return torch.stack(X), torch.tensor(y)
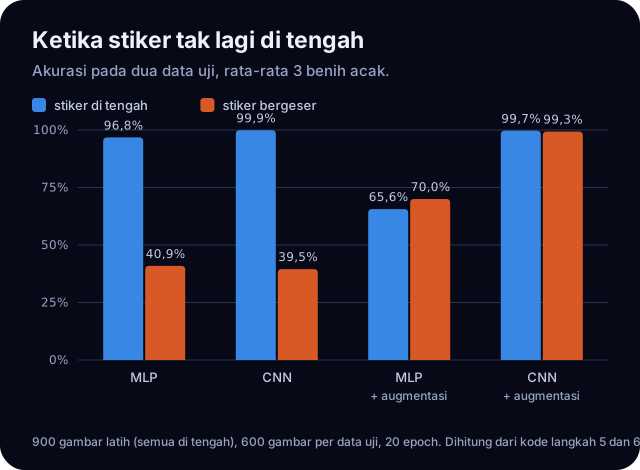
Lalu kita uji pada dua kumpulan baru, masing-masing 600 gambar: stiker di tengah, dan stiker yang bergeser sampai 8 piksel, seperti buku yang diletakkan miring oleh pengunjung yang terburu-buru. Rata-rata dari 3 benih acak:
Model
Stiker di tengah
Stiker bergeser
MLP
96,8%
40,9%
CNN
99,9%
39,5%
Di tengah, keduanya nyaris sempurna. Begitu stiker bergeser, keduanya jatuh ke sekitar 40%, tak jauh dari menebak asal untuk 3 kelas.
Hasil CNN mungkin mengejutkan. Bukankah konvolusi ikut bergeser bersama gambar? Benar, tetapi lapisan terakhirnya adalah lapisan linear yang punya bobot sendiri untuk setiap posisi di peta 8 × 8. Selama latihan ia hanya pernah melihat stiker di tengah, jadi bobot untuk posisi pinggir tak pernah belajar apa-apa.
Pelajarannya lebih besar dari stiker: model hanya andal pada data yang mirip data latihnya. Kamera di troli sungguhan akan menemui sudut, cahaya, dan jarak yang tak pernah ada di data latih. Selalu uji modelmu pada data yang sengaja dibuat berbeda.
6
Augmentasi: mengajari dengan variasi
Bila data latih kurang beragam, kita bisa membuat ragamnya sendiri. Augmentasi data mengubah setiap gambar secara acak setiap kali ia diambil, misalnya digeser, diputar, dipotong, atau dicerminkan, tanpa mengubah labelnya. Model jadi melihat versi baru dari setiap stiker di setiap epoch.
python
    def __getitem__(self, i: int) -> tuple[torch.Tensor, torch.Tensor]:
        x = self.X[i]
        return (self.ubah(x) if self.ubah else x), self.y[i]  # augmentasi baru setiap kali diambil


augmentasi = v2.RandomAffine(degrees=0, translate=(0.25, 0.25))  # geser acak sampai 25% lebar
v2.RandomAffine dari torchvision.transforms.v2 menggeser setiap gambar secara acak sampai 25% lebarnya, yaitu 8 piksel. Karena dipanggil di __getitem__, pergeserannya berbeda setiap kali gambar yang sama diambil.
Dihitung dari percobaan di langkah 5 dan 6.Lisensi: Karya sendiri
Dengan augmentasi, CNN bertahan di 99,3% pada stiker bergeser, dan di ketiga benih tak pernah di bawah 98,2%. MLP dengan augmentasi yang sama hanya mencapai 70,0%. Konvolusi membuat pelajaran dari satu posisi berlaku di posisi lain, sedangkan MLP harus mempelajari setiap posisi satu per satu.
Augmentasi termasuk teknik terpenting dalam computer vision. Makalah U-Net (2015) bahkan menyebut penggunaan augmentasi yang kuat sebagai kunci melatih jaringan dari sangat sedikit gambar.
Peringatan
Augmentasi tak boleh mengubah arti gambar. Mencerminkan foto kucing tetap kucing, tetapi memutar angka "6" setengah lingkaran mengubahnya menjadi "9". Pilih augmentasi yang sesuai dengan datamu.
7
Arsitektur yang mengubah sejarah
Banyak gagasan di halaman ini lahir dari lomba ImageNet Large Scale Visual Recognition Challenge (ILSVRC). Russakovsky dkk. (2015) menggambarkannya sebagai tolok ukur klasifikasi dan deteksi dengan ratusan kategori dan jutaan gambar, yang digelar setiap tahun sejak 2010. Beberapa arsitektur yang menandai perjalanannya:
Model
Tahun
Gagasan kunci
LeNet
1998
CNN yang dilatih dengan gradien untuk mengenali dokumen
AlexNet
2012
CNN besar di GPU: 60 juta parameter, dilatih pada 1,3 juta gambar untuk 1.000 kelas
VGG
2014
hanya filter kecil 3 × 3, ditumpuk sampai 16–19 lapisan berbobot
ResNet
2015
sambungan residual, sampai 152 lapisan; juara ILSVRC 2015 dengan galat 3,57%
Vision Transformer
2020
gambar dipotong menjadi tambalan dan diproses seperti token teks (langkah 10)
Ada satu benang merah. AlexNet membuktikan bahwa CNN besar yang dilatih di GPU pada data sangat banyak bisa jauh mengungguli metode lama: galat top-5 18,9% pada data uji ILSVRC-2010. VGG menunjukkan bahwa kedalaman penting. ResNet membuat kedalaman itu bisa dilatih. Vision Transformer membuktikan bahwa konvolusi pun tak mutlak wajib, asalkan data latihnya cukup besar.
Arsitektur-arsitektur ini tersedia siap pakai di torchvision.models, lengkap dengan bobot hasil latihan di ImageNet. Itulah bahan langkah berikutnya.
Transfer learning: meminjam mata yang sudah terlatih
Melatih ResNet dari nol butuh jutaan gambar dan berhari-hari GPU. Untungnya kamu tak perlu melakukannya. Dengan transfer learning, kamu memakai jaringan yang sudah dilatih di ImageNet, lalu hanya mengganti bagian akhirnya untuk tugasmu sendiri.
python
def siapkan(jumlah_kelas: int, unduh_bobot: bool = True) -> ResNet:
    bobot = ResNet18_Weights.DEFAULT if unduh_bobot else None  # DEFAULT = bobot terbaik yang tersedia
    model = resnet18(weights=bobot)
    for p in model.parameters():
        p.requires_grad = False  # bekukan: fitur ImageNet dipakai apa adanya
    model.fc = nn.Linear(model.fc.in_features, jumlah_kelas)  # kepala baru, satu-satunya yang dilatih
    return model
Tutorial resmi PyTorch menyebut dua cara:
Fitur tetap (seperti kode di atas): semua bobot dibekukan dengan requires_grad = False, lalu lapisan terakhir diganti dan hanya lapisan itu yang dilatih.
Fine-tuning: bobot ImageNet hanya dipakai sebagai titik awal, lalu seluruh jaringan ikut dilatih ulang dengan laju belajar kecil.
Uji kami memeriksa kode di atas tanpa mengunduh bobotnya. Dari 11.178.051 parameter ResNet-18, hanya 1.539 yang dilatih, yaitu kepala barunya. Sesudah backward(), hanya fc.weight dan fc.bias yang punya gradien.
Metadata bobotnya bisa dibaca tanpa mengunduh apa pun. ResNet18_Weights.DEFAULT mencatat 1.000 kategori ImageNet dan akurasi top-1 69,758%. weights.transforms() memberi resep praproses yang harus dipakai: ubah ukuran ke 256, potong tengah 224, lalu normalisasi dengan rata-rata dan simpangan baku ImageNet. Memakai praproses yang berbeda dari saat latihan adalah kesalahan yang sering terjadi.
Yosinski dkk. (2014) menjelaskan kenapa cara ini berhasil. Fitur lapisan awal bersifat umum dan berguna untuk banyak tugas, sedangkan lapisan akhir makin khusus untuk tugas aslinya. Karena itu, lapisan akhirlah yang paling perlu diganti.
9
Deteksi objek dan segmentasi
Sejauh ini model kita menjawab "stiker apa ini?". Rak yang difoto utuh memuat banyak buku sekaligus, jadi pertanyaannya bertambah:
Tugas
Keluarannya
Contoh model
klasifikasi
satu label per gambar
ResNet
deteksi objek
kotak pembatas + label untuk setiap benda
Faster R-CNN, YOLO
segmentasi semantik
label untuk setiap piksel
U-Net
segmentasi instans
topeng piksel terpisah untuk setiap benda
Mask R-CNN
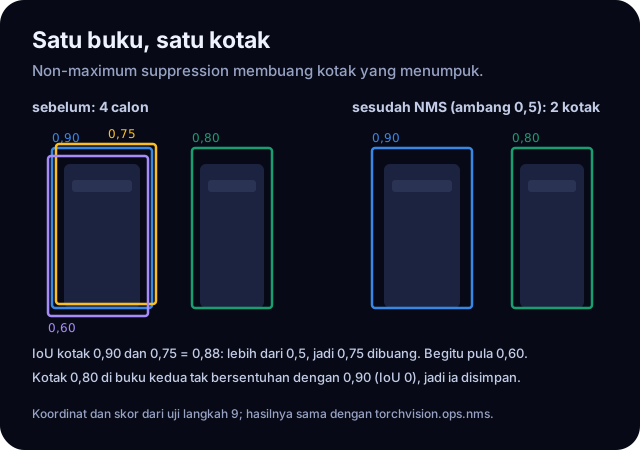
Detektor biasanya mengusulkan banyak kotak yang menumpuk untuk satu benda. Tumpang tindihnya diukur dengan IoU (intersection over union):
python
def iou(a: Kotak, b: Kotak) -> float:
    """Luas irisan dibagi luas gabungan: 1 bila kedua kotak sama persis, 0 bila tak bersentuhan."""
    lebar = max(0.0, min(a[2], b[2]) - max(a[0], b[0]))
    tinggi = max(0.0, min(a[3], b[3]) - max(a[1], b[1]))
    irisan = lebar * tinggi
    luas_a = (a[2] - a[0]) * (a[3] - a[1])
    luas_b = (b[2] - b[0]) * (b[3] - b[1])
    return irisan / (luas_a + luas_b - irisan)
Lalu non-maximum suppression (NMS) merapikannya:
python
def nms(kotak: list[Kotak], skor: list[float], ambang: float = 0.5) -> list[int]:
    """Simpan kotak berskor tertinggi, buang yang terlalu tumpang tindih dengannya, ulangi."""
    urutan = sorted(range(len(kotak)), key=lambda i: skor[i], reverse=True)
    simpan: list[int] = []
    for i in urutan:
        if all(iou(kotak[i], kotak[j]) <= ambang for j in simpan):
            simpan.append(i)
    return simpan
Koordinat dan skor dari uji di langkah ini.Lisensi: Karya sendiri
Keduanya memberi hasil yang sama dengan torchvision.ops.box_iou dan torchvision.ops.nms, juga pada 20 kotak acak.
Faster R-CNN (2015) memakai jaringan pengusul daerah yang berbagi fitur konvolusi dengan detektornya. YOLO (2015) memakai satu jaringan yang menebak semua kotak sekaligus, sekitar 45 gambar per detik. Mask R-CNN (2017) menambahkan cabang topeng piksel ke Faster R-CNN.
10
Vision Transformer: gambar sebagai deretan tambalan
Transformer lahir untuk teks. Dosovitskiy dkk. (2020) lalu bertanya: bagaimana bila gambar diperlakukan seperti kalimat? Jawabannya ada di judul makalah mereka, An Image is Worth 16x16 Words. Gambar dipotong menjadi tambalan 16 × 16 piksel, dan setiap tambalan diperlakukan seperti satu token.
python
def potong_tambalan(gambar: torch.Tensor, p: int = 16) -> torch.Tensor:
    """(C, H, W) -> (jumlah tambalan, C * p * p): satu baris per tambalan p x p."""
    C, H, W = gambar.shape
    t = gambar.reshape(C, H // p, p, W // p, p)  # pecah tinggi dan lebar menjadi kisi tambalan
    t = t.permute(1, 3, 0, 2, 4)  # (baris kisi, kolom kisi, C, p, p)
    return t.reshape((H // p) * (W // p), C * p * p)
Untuk gambar 224 × 224 dengan 3 kanal, hasilnya 14 × 14 = 196 tambalan, masing-masing berisi 16 × 16 × 3 = 768 angka. Uji kami memastikan tambalan pertama adalah pojok kiri atas, dan tambalan ke-15 adalah awal baris kedua.
Di torchvision, langkah ini dikerjakan oleh conv_proj, konvolusi 16 × 16 dengan stride 16. Uji kami membuktikan konvolusi itu sama persis dengan lapisan linear yang dikenakan pada setiap tambalan. Sesudahnya, satu token kelas ditambahkan di depan, sehingga model mengolah 197 posisi. Sisanya Transformer biasa: atensi membuat setiap tambalan bisa "melihat" semua tambalan lain, seperti setiap token melihat token lain di topik Large Language Model.
ViT-B/16 di torchvision berisi 86.567.656 parameter, dengan akurasi top-1 ImageNet 81,072% menurut metadata bobotnya. Makalahnya mencatat syaratnya. Transformer tak punya sebagian bias bawaan CNN, seperti lokalitas dan kepekaan terhadap pergeseran, sehingga kurang baik bila datanya sedikit. Dilatih dulu pada 14 sampai 300 juta gambar, ViT justru unggul.
Gagasan tambalan ini juga dipakai Claude. Dokumentasinya menyebut Claude melihat gambar dalam petak-petak 28 × 28 piksel, yang dibahas di langkah berikutnya.
11
Melihat dengan Claude
Semua model Claude saat ini menerima gambar, dikirim sebagai blok image bersumber base64, URL, atau file_id dari Files API. Dokumentasinya menyarankan gambar ditaruh sebelum teks.
python
def jelaskan(client: anthropic.Anthropic, berkas: Path, pertanyaan: str) -> str:
    respons = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": [
            {"type": "image", "source": {  # gambar lebih dulu, lalu teks
                "type": "base64", "media_type": "image/png",
                "data": base64.standard_b64encode(berkas.read_bytes()).decode(),
            }},
            {"type": "text", "text": pertanyaan},
        ]}],
    )
    return "".join(b.text for b in respons.content if b.type == "text")
Diuji dengan SDK anthropic asli dan server tiruan, tanpa biaya: blok gambar terkirim lebih dulu, dan base64-nya sama persis dengan isi berkas PNG.
Biayanya dihitung per token visual, satu token untuk setiap petak 28 × 28 piksel: math.ceil(lebar / 28) * math.ceil(tinggi / 28). Gambar 1000 × 1000 berarti 36 × 36 = 1.296 token. Dengan harga masukan Claude Opus 5.5, $4 per juta token, seribu gambar seperti itu memakan sekitar $5,18, belum termasuk teks dan jawabannya.
Gambar yang terlalu besar dikecilkan dulu dengan rasio sisi tetap:
Tingkat
Model
Sisi terpanjang
Token visual maksimum
resolusi tinggi
Claude 4.7 dan sesudahnya
2576 px
4784
standar
model lain
1568 px
1568
Kode uji kami menghitung ukuran itu, dan hasilnya cocok dengan implementasi rujukan di dokumentasi untuk 400 ukuran acak. Satu temuan kecil: untuk 2000 × 1500 di tingkat standar, tabel dokumentasi menulis 1269 × 952, sedangkan implementasi rujukannya menghasilkan 1270 × 952. Tokennya sama, 1564. Uji sendiri angka yang penting bagimu.
Batas lainnya: maksimum 8000 × 8000 piksel dan 10 MB per gambar, dengan format JPEG, PNG, GIF, atau WebP.
12
Batas computer vision: mudah dikelabui
Szegedy dkk. (2013) menemukan bahwa gangguan yang nyaris tak terlihat bisa membuat jaringan salah menebak. Goodfellow dkk. (2014) lalu memberi cara cepat membuatnya, FGSM: geser setiap piksel sedikit ke arah yang paling menaikkan loss.
python
def fgsm(model: nn.Module, x: torch.Tensor, y: torch.Tensor, eps: float) -> torch.Tensor:
    """Geser setiap piksel sejauh eps ke arah yang paling menaikkan loss (Goodfellow dkk., 2014)."""
    x = x.clone().requires_grad_(True)
    loss = nn.functional.cross_entropy(model(x), y)
    (grad,) = torch.autograd.grad(loss, x)  # turunan loss terhadap setiap piksel
    return (x + eps * grad.sign()).detach()
Kami menyerang CNN dengan augmentasi dari langkah 6, yang akurasinya 98,2% pada stiker bergeser. Sebagai pembanding, gangguan dengan besar yang sama tetapi arahnya acak:
Besar gangguan (eps)
Akurasi dengan FGSM
Akurasi dengan derau acak
0,05
48,8%
98,2%
0,1
7,7%
97,2%
0,2
1,0%
94,2%
Derau acak hampir tak berpengaruh. Gangguan yang dipilih dengan sengaja sebesar 0,1, sepersepuluh rentang kecerahan, menjatuhkan akurasi ke 7,7%. Model yang hebat pada data biasa belum tentu tangguh terhadap lawan yang mencari celahnya.
Batas lain yang sudah kamu temui: model rapuh terhadap data yang berbeda dari data latihnya (langkah 5). Dokumentasi Claude juga mencatat batas model vision secara terbuka:
Claude tak boleh dipakai untuk menyebut nama orang di gambar, dan menolaknya.
Ia bisa keliru pada gambar buram, terputar, atau sangat kecil, di bawah 200 piksel.
Hitungan benda dan koordinatnya hanya perkiraan.
Ia tak bisa memastikan apakah sebuah gambar dibuat AI.
Ia tak dirancang untuk membaca pindaian diagnosis seperti CT atau MRI.
Untuk keputusan penting, hasil computer vision, dari model mana pun, perlu diperiksa manusia.
SDK resmi untuk Messages API Claude di Python: tipe untuk definisi tool, blok tool_use dan tool_result, serta Tool Runner (beta) yang memutar putaran agen sendiri.
Dipakai di langkah 11 untuk mengirim gambar ke Claude sebagai blok image, dan di proyek kedua.
Pustaka deep learning sumber terbuka untuk Python: tensor yang bisa berjalan di GPU, autograd yang menghitung gradien secara otomatis, serta modul lapisan, fungsi loss, dan optimizer.
Dipakai di seluruh halaman untuk konvolusi, CNN, dan putaran latihan. Contoh diuji dengan versi 2.14.1 di CPU.
Pustaka pendamping PyTorch untuk computer vision: arsitektur model beserta bobot terlatihnya, transformasi dan augmentasi gambar, kumpulan data, serta operasi seperti IoU dan non-maximum suppression.
Dipakai untuk augmentasi (langkah 6), ResNet-18 (langkah 8), IoU dan NMS (langkah 9), serta ViT-B/16 (langkah 10). Contoh diuji dengan versi 0.29.1.
04
Mini Project
Misi
Pemilah benda di mejamu
Buat pengenal tiga jenis benda di sekitarmu, misalnya buku, cangkir, dan pena. Ambil sendiri fotonya dengan ponsel, setidaknya 50 foto per jenis, dari berbagai sudut.
Latih dua model: CNN kecil dari nol, dan ResNet-18 dengan transfer learning (kepala baru, bobot ImageNet dibekukan).
Pakai augmentasi dari torchvision.transforms.v2 untuk data latih saja, dan praproses weights.transforms() untuk ResNet.
Siapkan data uji kedua: foto yang diambil di ruangan, cahaya, atau latar yang berbeda.
Kamu selesai bila:
tabelmu membandingkan akurasi kedua model di data uji biasa dan data uji kedua;
kamu membandingkan hasil dengan dan tanpa augmentasi, dan menjelaskan bedanya;
jumlah parameter yang dilatih untuk setiap model dicatat;
kamu menampilkan 5 foto yang paling sering salah ditebak dan menebak penyebabnya;
data uji tak pernah dipakai untuk memilih model atau pengaturan.
Misi
Asisten katalog dengan Claude Vision
Proyek kedua melatih kebiasaan memakai model vision dengan hati-hati. Kumpulkan 10 foto sampul buku milikmu, lalu minta Claude membaca judul dan pengarangnya.
Sebelum mengirim, hitung ukuran yang akan dilihat Claude dan jumlah token visualnya, lalu perkirakan biayanya.
Kecilkan foto yang terlalu besar sendiri, supaya biaya dan hasilnya bisa diperkirakan.
Bandingkan jawaban Claude dengan judul dan pengarang yang kamu tulis sendiri.
Kamu selesai bila:
tabelmu memuat ukuran asli, ukuran yang dilihat, token visual, dan perkiraan biaya untuk setiap foto, lalu dibandingkan dengan usage dari respons;
kamu menghitung berapa judul dan pengarang yang terbaca benar;
kamu menguji setidaknya satu foto yang buram atau miring, dan mencatat apa yang terjadi;
kodemu menaruh gambar sebelum teks dan tak pernah meminta Claude menyebut nama orang di sampul.